 InSnap
Perché l'OCR ti restituisce la parola sbagliata invece di un errore

Il riconoscimento testo raramente dice di aver fallito. Restituisce una frase intera con un carattere sbagliato — quello che conta. Ecco dove accade e come accorgersene.
Copiare il testo da uno screenshot di solito funziona, ed è proprio questo il problema. Quando fallisce, raramente lo fa in modo rumoroso. Non c'è una sottolineatura rossa, né un «testo non riconosciuto», né un riquadro vuoto. C'è una frase che si legge perfettamente — tranne un carattere, e quel carattere cambia il significato.
Ecco perché le persone incollano un numero d'ordine sbagliato di una cifra, una chiave di configurazione con una lettera sbagliata, o una frase in un documento con un carattere che non c'era mai stato. Il riconoscimento non è andato in crash. Ha tirato a indovinare con sicurezza.
Il riconoscimento è un classificatore, non un parser
Aiuta sapere cosa fa davvero il motore. Il riconoscimento testo divide l'immagine in righe, poi in regioni a forma di carattere, poi passa ogni regione a un classificatore che restituisce il carattere più probabile. Quel classificatore non dice mai «non lo so». Restituisce sempre la corrispondenza più vicina che riesce a trovare.
Con una buona qualità di input quella corrispondenza più vicina è giusta quasi ovunque. Con una qualità scarsa la corrispondenza più vicina è un carattere diverso che capita di somigliare: una a che potrebbe essere una o, un 1 che potrebbe essere una l, oppure un carattere CJK che potrebbe facilmente essere scambiato per un vicino con un componente in comune. Il motore non ha idea di sbagliare.
Cosa rende l'input «scadente»
Contano quattro cose, all'incirca in quest'ordine:
- Altezza del testo in pixel. Un testo più piccolo ha meno pixel da classificare. Questo è il fattore grosso.
- Il set di caratteri. I caratteri cinesi, giapponesi e coreani sono densi; qualche pixel perso cambia sia la forma sia l'identità del carattere. Le lettere latine sono più semplici e resistono più a lungo.
- Antialiasing e ridimensionamento. Ogni ridimensionamento sfuma i bordi di ogni tratto. Un ridimensionamento va bene; tre, in fila, perdono la forma.
- Contrasto e sfondo. Grigio su bianco e chiaro su scuro riducono entrambi la forza dei bordi. Lo stesso fanno i gradienti e le foto dietro il testo.
La maggior parte delle segnalazioni di errore nasce dal primo punto, e la soluzione di solito è catturare più pixel, non impegnarsi di più.
InSnap non ha un'impostazione di precisione separata. Lavora sui pixel che selezioni: uno screenshot 1x di un'interfaccia densa ha già ogni riga all'altezza con cui lo schermo l'ha disegnata, e una cattura Retina 2x ha il doppio di quella. La differenza tra le due, per un dato paragrafo di testo, è spesso la differenza tra corretto e plausibile-ma-sbagliato.

Dove sta la linea pratica
Per vedere il confine invece di immaginarlo, vale la pena costruire un piccolo test ripetibile: renderizza la stessa frase a varie altezze di testo, esegui il riconoscimento su ciascuna e confronta l'output con l'input carattere per carattere. È esattamente ciò che fanno le due immagini qui sotto, usando l'output reale di un motore locale, non esempi inventati.
La riga cinese e la riga inglese sono state renderizzate a cinque altezze e riconosciute da capo ogni volta. Il rosso segna i caratteri che differiscono dall'originale.
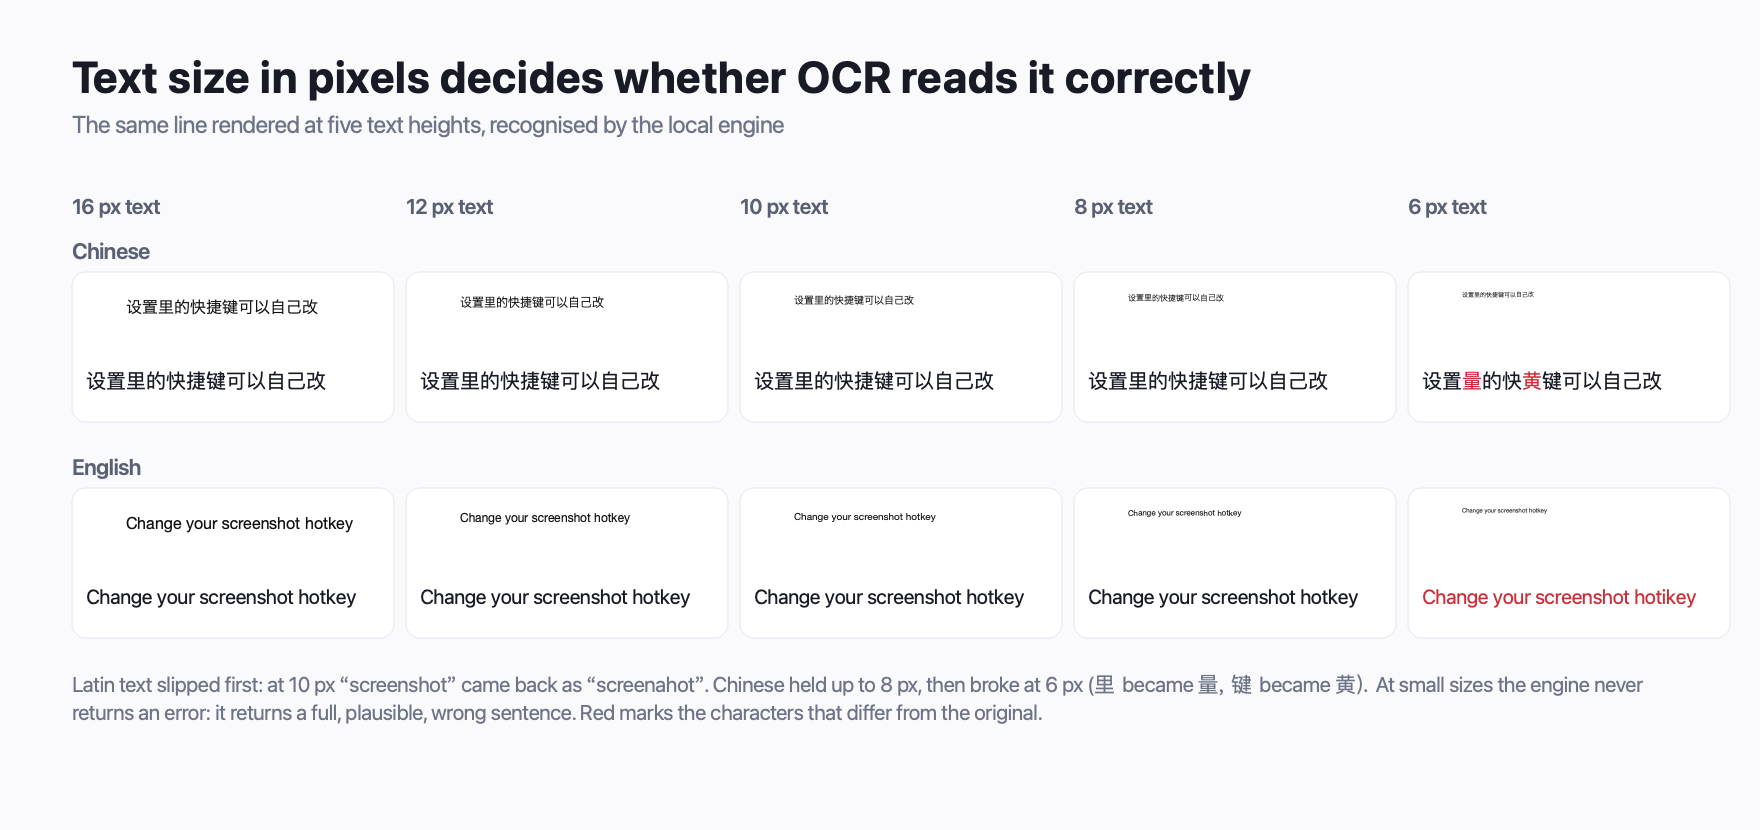
Se ne ricavano due cose. Primo, la riga è corretta finché a un certo punto non lo è più: non c'è un degrado graduale, solo una dimensione sotto la quale compare il carattere sbagliato. Secondo, le due scritture cedono in punti diversi. Qui il testo latino ha ceduto prima, mentre il cinese ha tenuto più a lungo: l'opposto di ciò che la maggior parte delle persone presume da «il cinese è più difficile».
Quando la stessa frase viene riconosciuta a dimensioni ancora più piccole, l'output diventa un altro tipo di sbagliato. Non vuoto, non senza senso, ma una frase reale con caratteri reali e sbagliati:
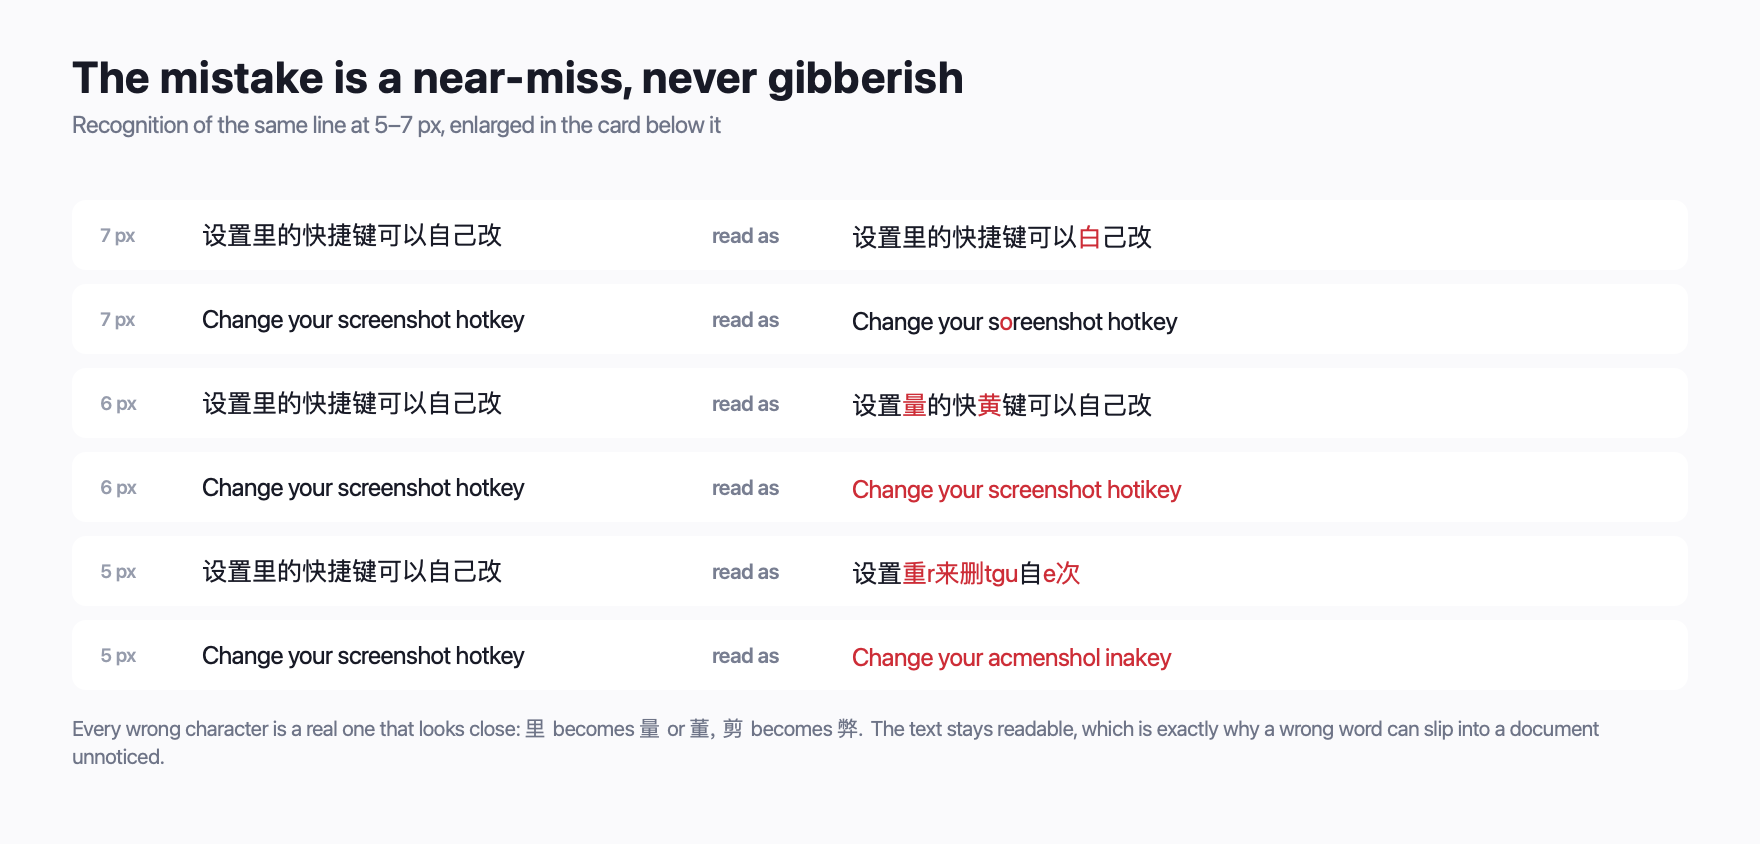
La seconda immagine è quella utile. Mostra che aspetto ha davvero un risultato sbagliato: non abbastanza evidente da notarlo, non abbastanza sottile da essere niente.
Come accorgersene prima che arrivi in un documento
Il riconoscimento non ti può dire che è incerto, quindi devi controllare nei punti in cui un carattere sbagliato costa caro.
- Controlla tutto ciò che contiene numeri o identificatori. ID d'ordine, chiavi di licenza, stringhe di versione, totali di fattura. Una singola cifra sbagliata è invisibile nel contesto e fatale a valle.
- Controlla la lunghezza. Un identificatore di due caratteri che torna come tre, o il contrario, è un segnale affidabile che qualcosa è andato storto.
- Controlla i caratteri insoliti. Barre verticali, spazi, spazi non separabili, confusione tra cirillico e latino. Se il testo è codice, incollarlo in una vista a spaziatura fissa rende evidenti queste cose.
- Controlla i bordi. I caratteri all'inizio o alla fine di una riga sono i primi a essere tagliati durante il rilevamento. Se una riga finisce bruscamente, guarda gli ultimi uno o due caratteri.
- Ricattura a una dimensione maggiore, non ingrandire. Ingrandire una riga sfocata non crea dettaglio, e raramente corregge un carattere sbagliato. Ricatturare la stessa area a 2x, oppure zoomare la fonte prima di catturare, sì.
Il corollario pratico è che uno screenshot preso con una selezione ampia a buona risoluzione è più facile da riconoscere di uno minuscolo e ritagliato stretto. Ritagliare riduce il rumore, ma rimpicciolire riduce l'informazione, e l'informazione è ciò di cui si nutre il classificatore.
Su cosa puoi contare
Il riassunto onesto:
| Situazione | Di solito va bene | Di solito no |
|---|---|---|
| Testo inglese e in alfabeto latino a dimensione normale di interfaccia | Sì | — |
| Cinese a dimensione normale di interfaccia | Sì | — |
| Testo alto all'incirca meno di 10 px | — | No |
| Kana giapponesi, coreano, russo | — | No |
| Testo sopra una foto o un gradiente | A volte | A volte |
| Screenshot ridimensionati pesantemente | — | No |
Il riconoscimento locale di InSnap gestisce bene cinese, inglese e le lingue in alfabeto latino, compresi i caratteri accentati. Non è affidabile con kana giapponesi, coreano o russo. È una proprietà del modello incluso, non un'impostazione, quindi la mossa onesta per quelle scritture è verificare tutto ciò che copi.
Domande frequenti
Il riconoscimento testo mi dice quando è incerto?
No. Un classificatore di caratteri restituisce sempre una migliore ipotesi, e l'interfaccia non ha un indicatore di confidenza separato per la copia. L'assunzione sicura è che qualsiasi carattere restituito sia il più probabile, non uno garantito.
Posso correggere un carattere sbagliato eseguendolo di nuovo?
Di solito no, perché l'input non è cambiato e il modello è deterministico sugli stessi pixel. La correzione è cambiare l'input: ricattura la stessa regione a una dimensione maggiore, oppure ingrandisci la fonte prima di catturare, poi riconosci di nuovo.
Perché funziona su uno screenshot e fallisce su un altro della stessa pagina?
Il più delle volte è la dimensione del testo in pixel, che dipende dalla scala del display e dal fatto che la cattura fosse a 1x o 2x. La stessa pagina a uno zoom diverso o su un display diverso può attraversare il confine di dimensione.
Legge il testo dentro immagini e foto?
Solo se il testo è grande e nitido su uno sfondo semplice. È sul testo sopra una foto, un gradiente o un'illustrazione complessa che compaiono più spesso i caratteri sbagliati.
Serve una connessione internet perché funzioni?
No. Il riconoscimento gira in locale, compreso il passaggio di copia. Nulla viene caricato, e la precisione è la stessa offline.
Altro dal blog

Come ottenere risultati OCR migliori da uno screenshot
Il riconoscimento del testo vale quanto i pixel che gli dai. Ritaglia stretto, mantieni la risoluzione, evita inclinazioni e sfondi caotici e conosci i limiti di lingua.
25 ottobre 2026
Come copiare il testo da uno screenshot o un'immagine su Mac e Windows
Trasforma le parole di uno screenshot in testo copiabile. Le opzioni integrate di Mac e Windows e un flusso OCR rapido, sul dispositivo, con InSnap.
23 ottobre 2026
Come copiare il testo da un video o da un fotogramma
Sottotitoli, slide, messaggi d'errore e codice sono pur sempre testo. Metti in pausa sul fotogramma, cattura l'area ed esegui l'OCR per copiarlo, senza riscriverlo.
25 ottobre 2026
Come si aggiorna InSnap (e come controllare manualmente)
Controlli automatici, la voce di menu manuale e la differenza tra versione installata e portatile di Windows. Cosa conserva un aggiornamento e cosa fare se fallisce.
25 ottobre 2026