 InSnap
Por que o OCR devolve a palavra errada em vez de um erro

O reconhecimento de texto raramente avisa que falhou. Ele devolve uma frase inteira com um caractere errado — justo o que importa. Veja onde isso acontece e como notar.
Copiar texto de uma captura de tela normalmente funciona, e esse é o problema. Quando falha, raramente falha alto. Não há sublinhado vermelho, nem "não foi possível reconhecer o texto", nem caixa vazia. Há uma frase que se lê perfeitamente bem — exceto por um caractere, e esse caractere muda o sentido.
É por isso que as pessoas colam um número de pedido errado em um dígito, uma chave de configuração com uma letra trocada, ou uma frase num documento com um caractere que nunca esteve ali. O reconhecimento não travou. Ele chutou com confiança.
O reconhecimento é um classificador, não um analisador
Ajuda saber o que o mecanismo realmente faz. O reconhecimento de texto divide a imagem em linhas, depois em regiões com formato de caractere, e então passa cada região por um classificador que devolve o caractere mais provável. Esse classificador nunca diz "não sei". Ele sempre devolve a melhor correspondência que encontra.
Com boa qualidade de entrada, essa melhor correspondência está certa em quase tudo. Com qualidade ruim, a melhor correspondência é um caractere diferente que por acaso parece parecido: um a que poderia ser um o, um 1 que poderia ser um l, ou um caractere CJK que poderia facilmente ser confundido com um vizinho de componente parecido. O mecanismo não tem ideia de que está errado.
O que torna a entrada "ruim"
Quatro coisas importam, mais ou menos nesta ordem:
- Altura do texto em pixels. Texto menor tem menos pixels para classificar. Esse é o principal.
- O conjunto de caracteres. Caracteres de chinês, japonês e coreano são densos; alguns pixels perdidos mudam tanto a forma quanto a identidade do caractere. Letras latinas são mais simples e resistem por mais tempo.
- Suavização e escala. Todo redimensionamento mistura as bordas de cada traço. Um redimensionamento tudo bem; três, empilhados, perdem a forma.
- Contraste e fundo. Cinza sobre branco e claro sobre escuro reduzem a força das bordas. Gradientes e fotos atrás do texto também.
A maior parte dos relatos de falha vem do primeiro, e a correção costuma ser capturar mais pixels, não se esforçar mais.
O InSnap não tem uma configuração separada de precisão. Ele trabalha sobre os pixels que você seleciona: uma captura 1x de uma interface densa já tem cada linha na altura em que a tela a desenhou, e uma captura Retina 2x tem o dobro disso. A diferença entre as duas, para um determinado parágrafo de texto, muitas vezes é a diferença entre certo e plausível-mas-errado.

Onde fica a linha prática
Para ver o limite em vez de adivinhá-lo, vale montar um teste pequeno e repetível: renderize a mesma frase em várias alturas de texto, rode o reconhecimento em cada uma e compare a saída com a entrada caractere por caractere. É exatamente o que as duas imagens abaixo fazem, usando saída real de um mecanismo local, não exemplos inventados.
A linha em chinês e a linha em inglês foram renderizadas em cinco alturas e reconhecidas de novo a cada vez. O vermelho marca os caracteres que diferem do original.
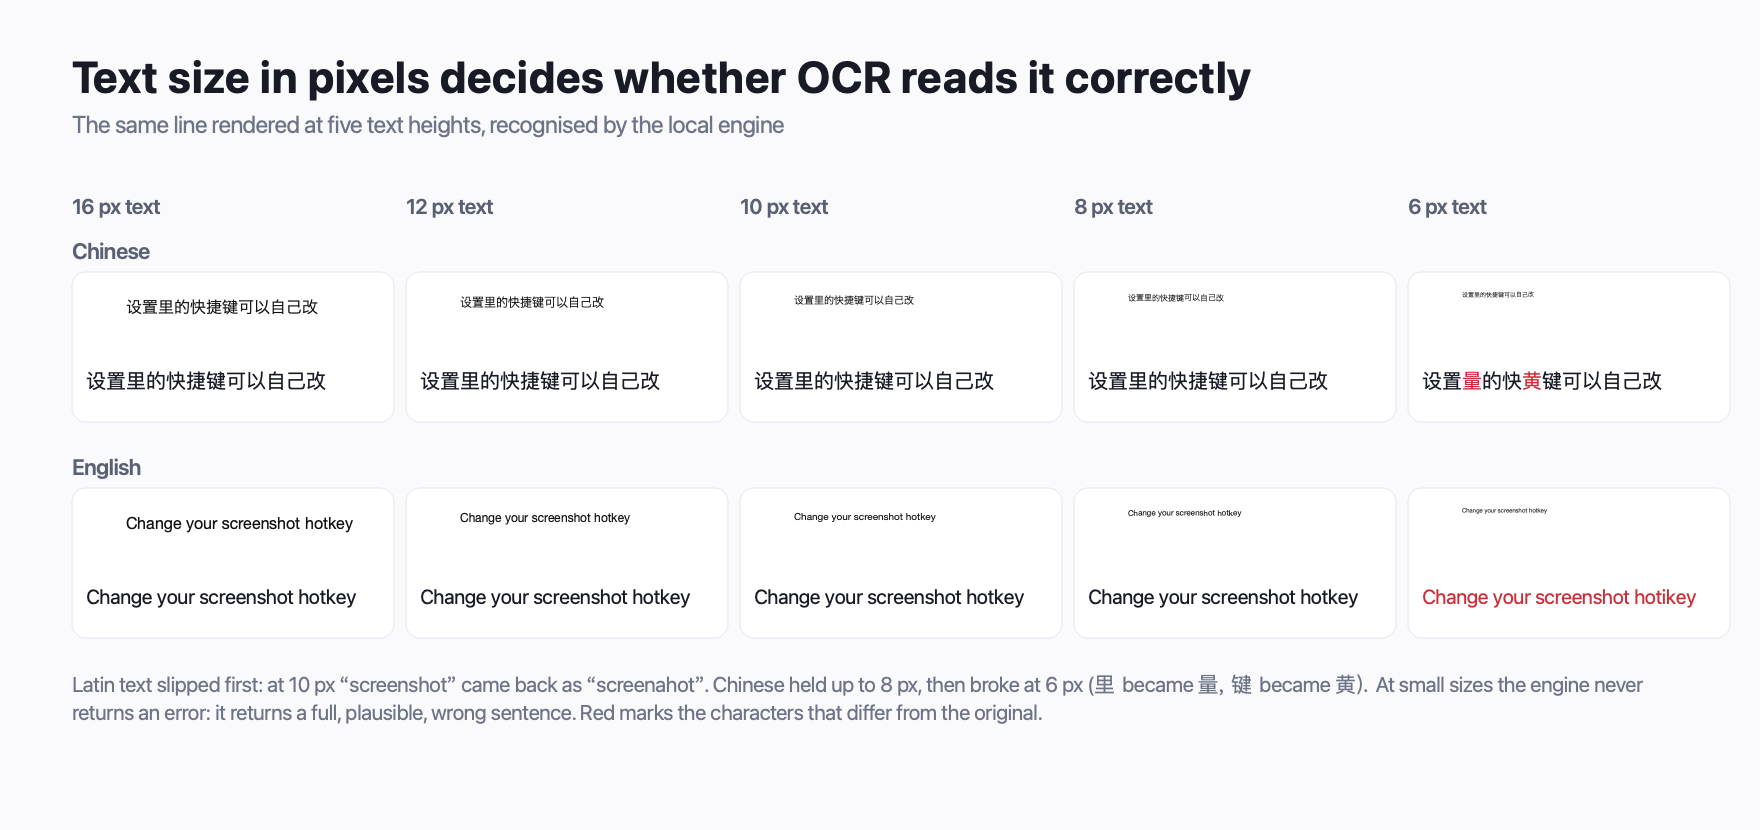
Duas coisas saem disso. Primeiro, a linha está certa até deixar de estar: não há degradação gradual, apenas um tamanho abaixo do qual o caractere errado aparece. Segundo, os dois sistemas de escrita quebram em pontos diferentes. O texto latino falhou mais cedo aqui, enquanto o chinês aguentou mais, o que é o contrário do que a maioria assume a partir de "chinês é mais difícil".
Quando a mesma frase é reconhecida em tamanhos ainda menores, a saída se torna um tipo diferente de errado. Não vazia, não sem sentido, mas uma frase de verdade com caracteres reais e errados:
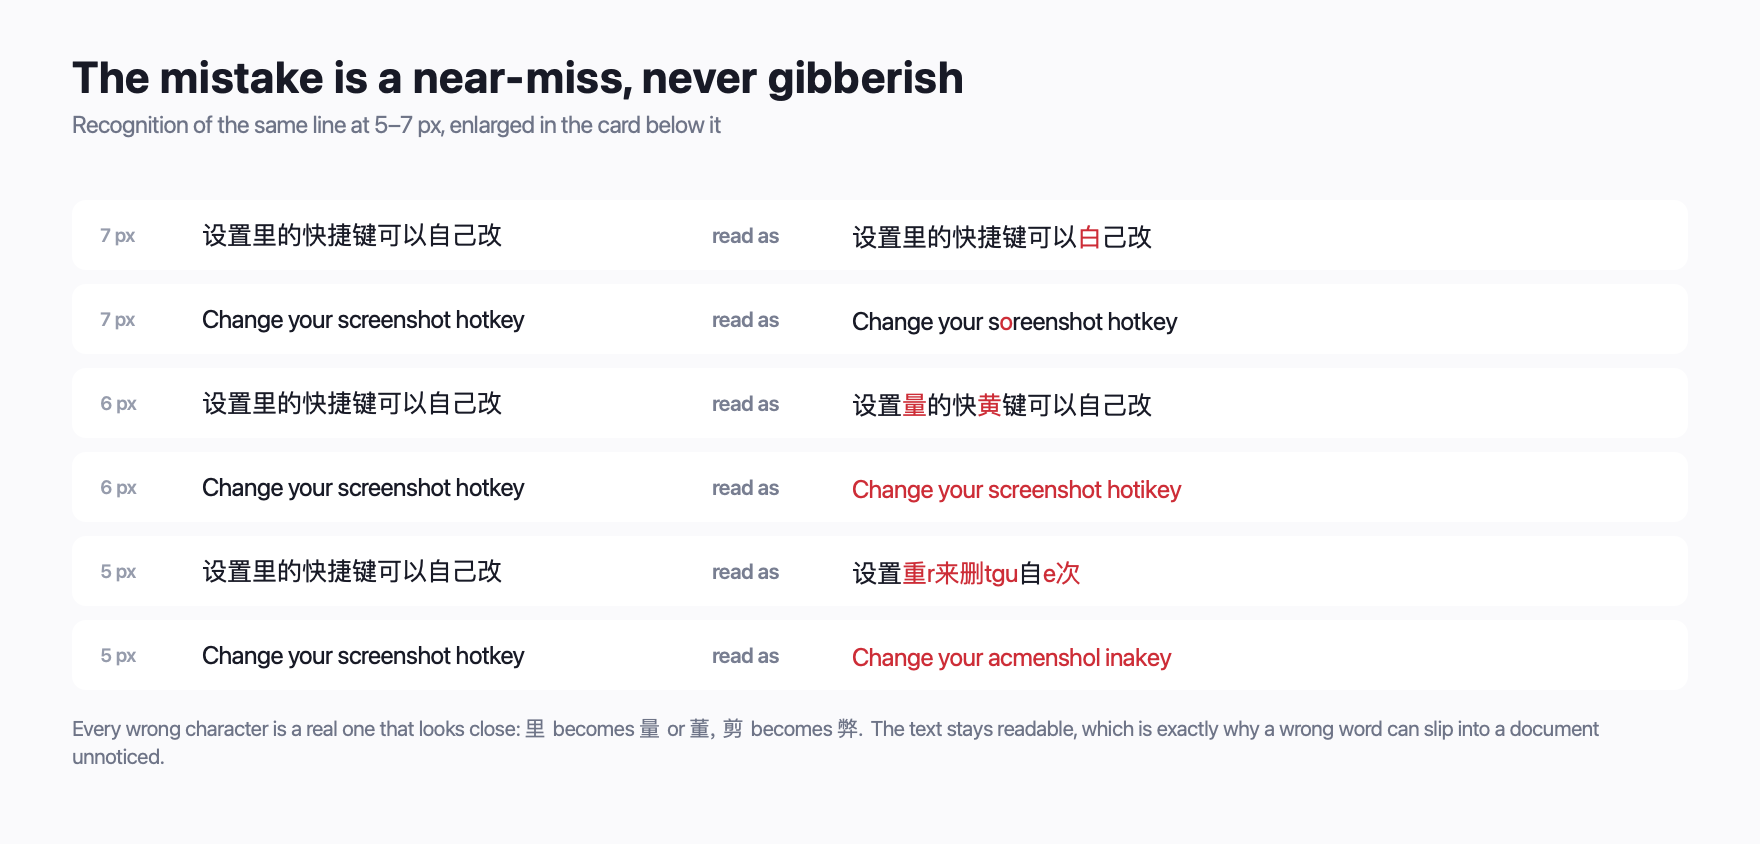
Essa segunda imagem é a útil. Ela mostra como um resultado errado realmente se parece: não óbvio o bastante para você notar, não sutil o bastante para ser nada.
Como perceber antes que chegue a um documento
O reconhecimento não consegue dizer que está em dúvida, então você precisa conferir nos lugares em que um caractere errado sai caro.
- Confira qualquer coisa com números ou identificadores. IDs de pedido, chaves de licença, strings de versão, totais de nota fiscal. Um único dígito errado fica invisível no contexto e é fatal depois.
- Confira o comprimento. Um identificador de dois caracteres que voltou com três, ou o contrário, é um sinal confiável de que algo deu errado.
- Confira caracteres incomuns. Barras verticais, espaços, espaços não separáveis, confusão entre cirílico e latino. Se o texto for código, colar numa visualização monoespaçada deixa isso óbvio.
- Confira as bordas. Caracteres no começo ou no fim de uma linha são os primeiros a serem cortados na detecção. Se uma linha termina de repente, olhe os últimos um ou dois caracteres.
- Capture de novo num tamanho maior, não amplie. Ampliar uma linha embaçada não cria detalhe e raramente corrige um caractere errado. Capturar de novo a mesma área em 2x, ou dar zoom na origem antes de capturar, corrige.
O corolário prático é que uma captura feita com uma seleção ampla em boa resolução é mais fácil de reconhecer do que uma minúscula recortada apertada. Recortar reduz o ruído, mas encolher reduz a informação, e é de informação que o classificador se alimenta.
No que você pode confiar
O resumo honesto:
| Situação | Costuma funcionar | Costuma não funcionar |
|---|---|---|
| Texto em inglês e em escrita latina no tamanho normal de interface | Sim | — |
| Chinês no tamanho normal de interface | Sim | — |
| Texto com menos de aproximadamente 10 px de altura | — | Não |
| Kana japonês, coreano, russo | — | Não |
| Texto sobre uma foto ou gradiente | Às vezes | Às vezes |
| Capturas muito redimensionadas | — | Não |
O reconhecimento local do InSnap lida bem com chinês, inglês e idiomas de escrita latina, incluindo caracteres acentuados. Ele não é confiável para kana japonês, coreano ou russo. Isso é uma propriedade do modelo incluído, não uma configuração, então o movimento honesto para essas escritas é verificar qualquer coisa que você copiar.
Perguntas frequentes
O reconhecedor de texto avisa quando está em dúvida?
Não. Um classificador de caracteres sempre devolve o melhor palpite, e a interface não tem um indicador separado de confiança para a cópia. A suposição segura é que qualquer caractere que ele devolve é o mais provável, não o garantido.
Posso corrigir um caractere errado rodando de novo?
Normalmente não, porque a entrada não mudou e o modelo é determinístico sobre os mesmos pixels. A correção é mudar a entrada: capturar de novo a mesma região num tamanho maior, ou dar zoom na origem antes de capturar, e então reconhecer outra vez.
Por que funciona numa captura de tela e falha em outra da mesma página?
Na maioria dos casos, o tamanho do texto em pixels, que depende da escala da tela e de a captura ter sido em 1x ou 2x. A mesma página com outro zoom ou em outra tela pode cruzar o limite de tamanho.
Ele lê texto dentro de imagens e fotos?
Só se o texto for grande e claro sobre um fundo liso. Texto sobre uma foto, um gradiente ou uma ilustração complexa é onde os caracteres errados mais aparecem.
Preciso de conexão com a internet para isso funcionar?
Não. O reconhecimento roda localmente, incluindo a etapa de cópia. Nada é enviado, e a precisão é a mesma offline.
Mais do blog

Como obter melhores resultados de OCR em uma captura de tela
O reconhecimento de texto depende dos pixels que você fornece. Corte justo, preserve a resolução, evite inclinação e fundos carregados e conheça os limites.
25 de outubro de 2026
Como copiar texto de uma captura de tela ou imagem no Mac e Windows
Transforme as palavras de uma captura de tela em texto que você pode copiar. Opções nativas no Mac e no Windows, além de um fluxo rápido de OCR local com o InSnap.
23 de outubro de 2026
Como copiar texto de um vídeo ou de um quadro pausado
Legendas, slides, mensagens de erro e código em um vídeo ainda são texto. Pause no quadro, capture a área e use o OCR para copiar sem redigitar.
25 de outubro de 2026
Como o InSnap se atualiza (e como verificar manualmente)
Verificações automáticas, o item de menu manual e a diferença entre as versões instalada e portátil do Windows. O que uma atualização mantém e o que fazer se ela falhar.
25 de outubro de 2026