 InSnap
为什么 OCR 不报错,却给出一个错字

文字识别很少说「我失败了」。它交回来的是一整句通顺的话,只有一个字是错的——偏偏就是关键的那个。本文说明这种情况从哪来、该怎么发现。
从截图里复制文字通常都能成,问题也正出在这里。它失败的时候,很少失败得明显:没有红色波浪线,没有「无法识别文字」,也没有空白的框。交回来的是一句读起来完全通顺的话——只有一个字不对,而这一个字改变了意思。
所以人们会贴出一个少了一位的订单号、一个字母写错的配置项、一句文档里凭空多出来的字。识别没有崩,它只是很有把握地猜错了。
识别是分类器,不是解析器
先搞清楚引擎到底在做什么,会好理解得多。文字识别先把图像切成行,再切成一个个字符形状的区域,然后让每个区域过一个分类器,返回最可能的那个字符。这个分类器从不说「我不知道」,它永远返回它找得到的最近匹配。
输入质量好的时候,这个最近匹配几乎处处都对。质量差的时候,最近匹配就是另一个碰巧长得很像的字符:可能是 o 的 a,可能是 l 的 1,或者是一个和邻居共用偏旁、很容易认错的中文字。引擎根本不知道它错了。
什么样的输入算「差」
大致按这个顺序,有四件事起作用:
- 文字的高度(像素)。 字越小,可供分类的像素越少。这是最主要的因素。
- 字符集。 中日韩文字笔画密集,丢掉几个像素,形状和身份都会变。拉丁字母结构简单,能撑得更久。
- 抗锯齿和缩放。 每一次缩放都会把每一笔的边缘糊开。缩一次还行,连缩三次形状就没了。
- 对比度和背景。 白底灰字、深底浅字都会削弱边缘;文字背后的渐变和照片也一样。
绝大多数「识别失败」的报告都来自第一条,而解决办法通常是多抓些像素,而不是「再努力一点」。
InSnap 没有单独的准确率设置。它就在你框出的那块像素上工作:密排界面的一张 1x 截图,每一行的高度就是屏幕画出来的那个高度;2x 的 Retina 截图则有一倍之多。对同样一段文字来说,这两者的差距,常常就是「正确」和「读得通但是错的」之间的差距。

实际的边界在哪里
与其凭感觉猜边界,不如搭一个小而可重复的测试:把同一句话按几种不同的字高渲染出来,逐一识别,再和原文逐字比对。下面两张图就是这么做的,用的是本地引擎的真实输出,不是编出来的示例。
中文行和英文行各按五个高度渲染,每次重新识别。红色标出与原句不同的字符。
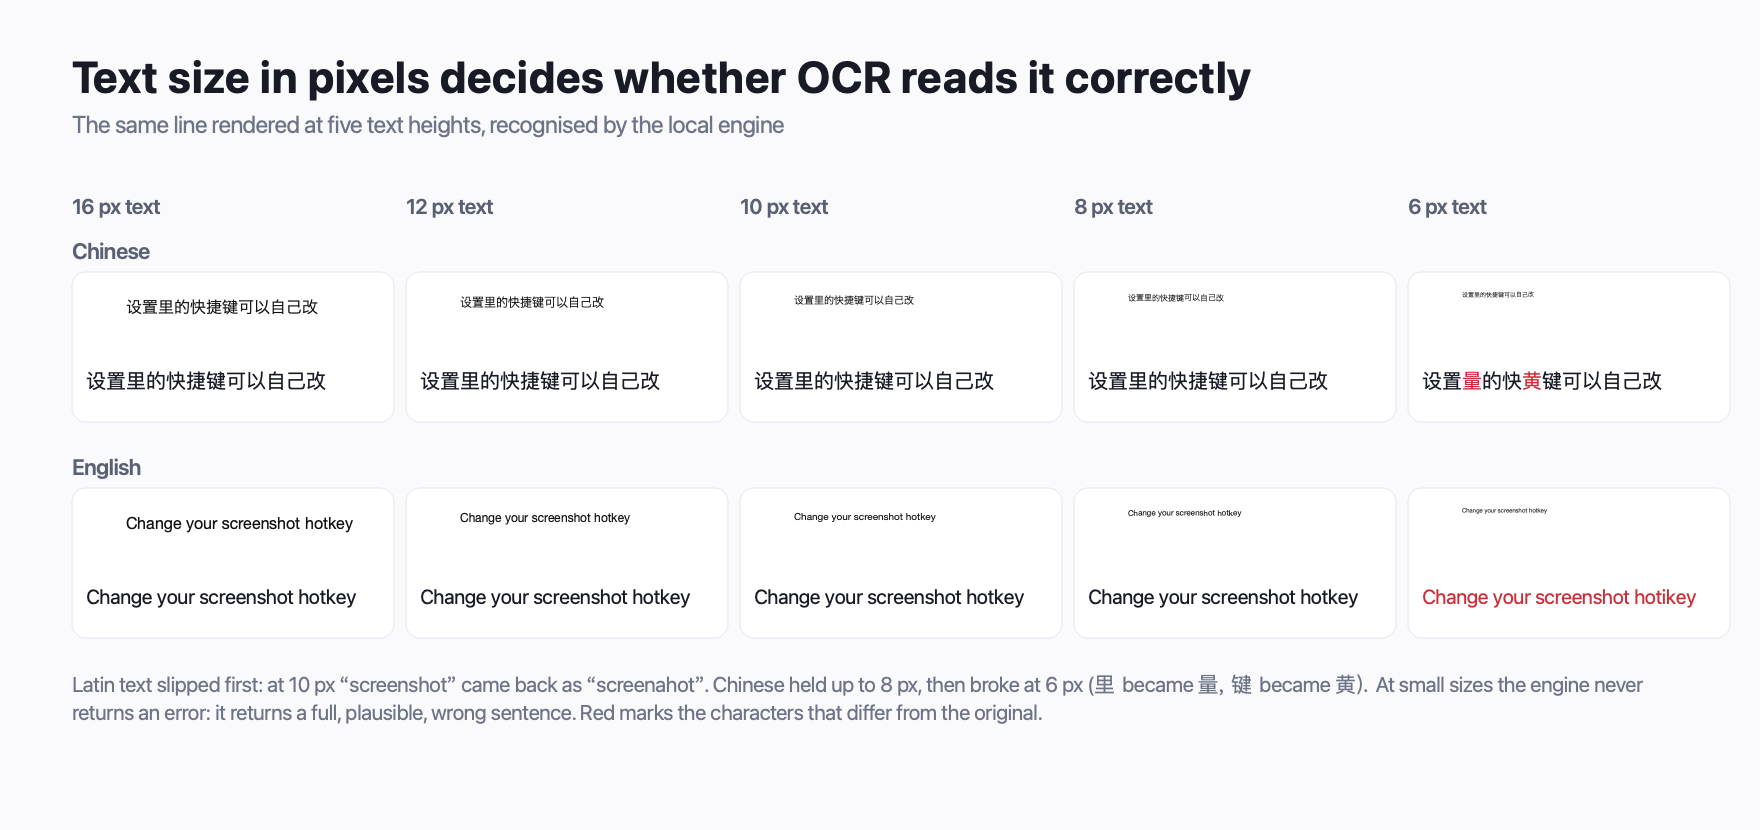
可以得出两点。第一,一行要么对、要么突然不对:没有渐变的过程,只是低于某个尺寸就冒出错的字。第二,两种文字断掉的位置不一样。这里拉丁字母反而先撑不住,中文坚持得更久——这与大多数人从「中文更难」得出的预期正好相反。
如果把同一句话放到更小的尺寸去识别,输出就变成另一种错法:不是空白,也不是乱码,而是一句真实的句子,里面是真实存在、但并不正确的字:
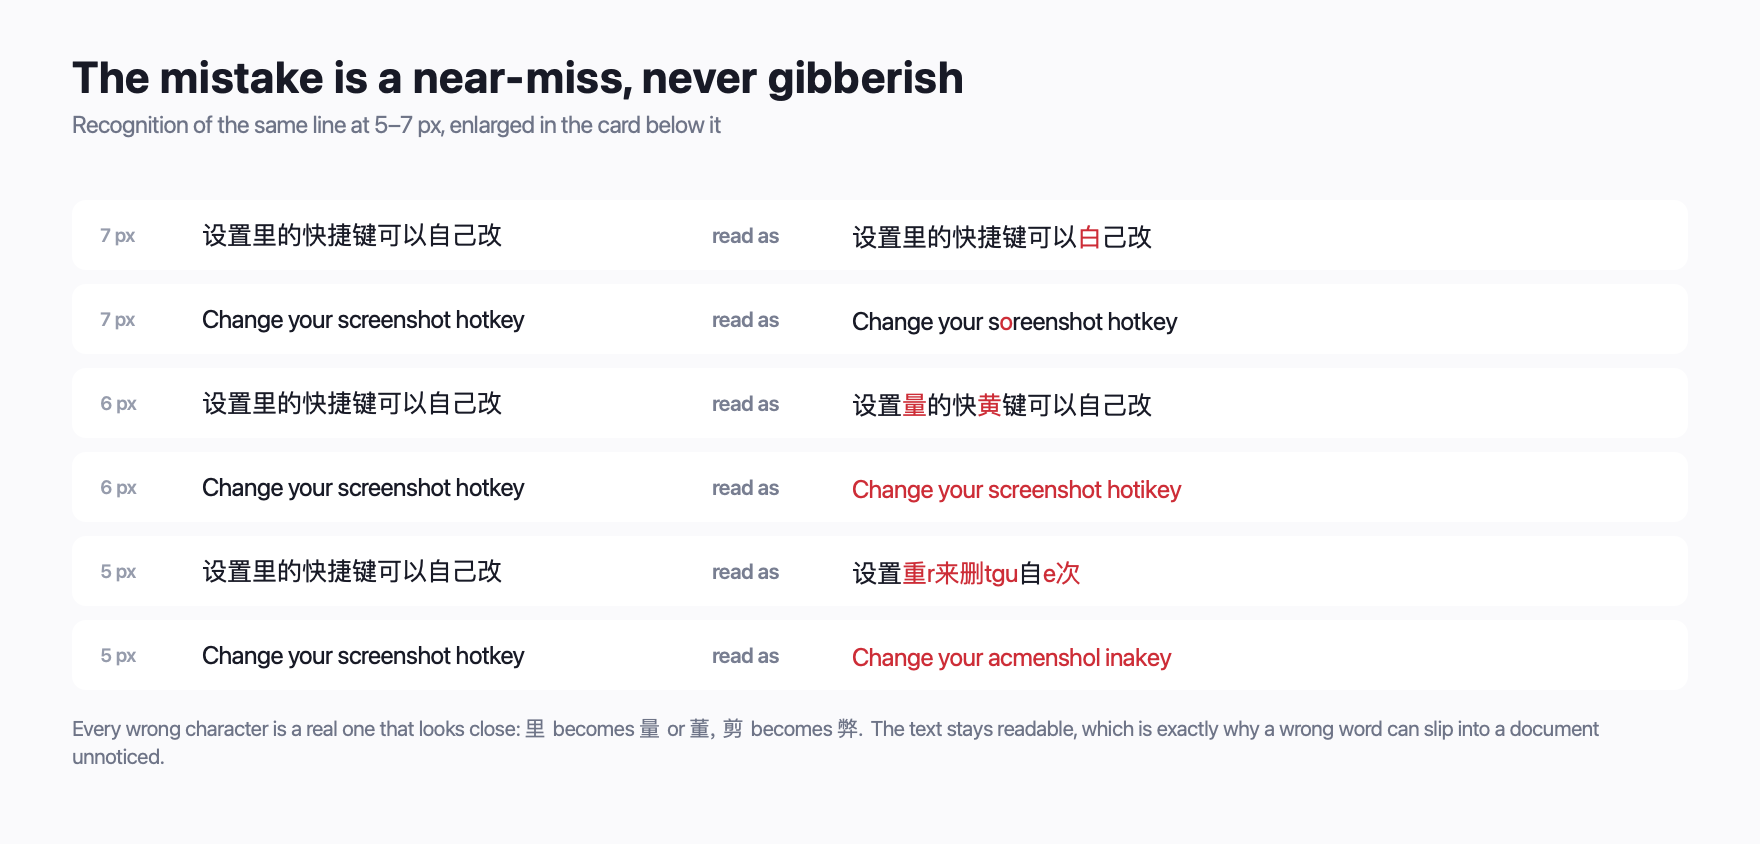
第二张图才是有用的那张。它展示了错误结果真实的样子:不够明显,以至于容易被忽略;也没虚弱到可以当作没发生。
怎么在它进入文档之前发现
识别没法告诉你它没把握,所以凡是错一个字代价很大的地方,都得自己核。
- 核对带数字或标识符的内容。 订单号、许可密钥、版本号、发票金额。在上下文里错一位数字完全看不出来,到了下游却是致命的。
- 核对长度。 两个字符的标识符回来变成三个,或者反过来,都是明确的出错信号。
- 核对特殊字符。 竖线、空格、不间断空格、西里尔字母和拉丁字母的混淆。如果内容是代码,粘进等宽视图里一眼就能看出来。
- 核对首尾。 行首和行尾的字符在检测阶段最先被切掉。如果一行结束得很突然,看看最后一两个字符。
- 放大重新截,而不是把图放大。 把模糊的一行放大并不会产生细节,也基本修不好错字;把同一块区域按 2x 重截、或者截之前先把页面放大,才行。
由此得出的实用推论是:选区宽一点、分辨率高一点的截图,比一张裁得很紧的小图更容易识别。裁剪能减少噪声,缩小却会减少信息,而信息正是分类器的食粮。
哪些可以放心
诚实地说:
| 情况 | 通常没问题 | 通常不行 |
|---|---|---|
| 正常界面尺寸的英文和拉丁字母文字 | 是 | — |
| 正常界面尺寸的中文 | 是 | — |
| 高度大致低于 10 px 的文字 | — | 不行 |
| 日文假名、韩文、俄文 | — | 不行 |
| 压在照片或渐变上的文字 | 有时 | 有时 |
| 反复缩放过的截图 | — | 不行 |
InSnap 的本地识别对中文、英文和拉丁字母语言(含带重音符号的字符)处理得很好,对日文假名、韩文和俄文不可靠。这是随包模型的属性,不是一个设置项,所以对这几类文字,诚实的做法是复制出来的东西都核一遍。
常见问题
文字识别会告诉我它没把握吗?
不会。字符分类器永远返回一个最佳猜测,界面在复制时也没有单独的置信度提示。稳妥的假设是:它返回的每个字符都只是「最可能」,不是「保证正确」。
再识别一次能把错字改对吗?
通常不能,因为输入没变,而模型对同样的像素是确定性的。办法是换输入:把同一区域按更大的尺寸重新截,或者在截之前先把页面放大,然后再识别。
为什么同一个页面,一张截图能识别、另一张就不行?
最常见的原因是文字在像素上的大小,而它取决于显示缩放,以及截图是 1x 还是 2x。同一个页面换个缩放比例、或换块屏幕,就可能跨过那条尺寸线。
它能否识别图片和照片里的文字?
只有当文字够大够清楚、背景又平坦时才行。文字压在照片、渐变或复杂插画上,正是错字最常出现的地方。
需要联网才能用吗?
不需要。识别在本机运行,复制这一步也是。什么都不会上传,离线时准确率也一样。
博客里的更多文章

如何让截图的 OCR 识别结果更准确
文字识别的好坏取决于你给它的像素。裁紧一点、保住分辨率、避开倾斜和杂乱背景,并了解它的语言限制。
2026年10月25日
如何复制截图里的文字(Mac 与 Windows 文字识别)
把截图里的文字变成可以复制、粘贴的文本。介绍 Mac 与 Windows 自带的方法,以及用 InSnap 在本机完成的快速 OCR 流程。
2026年10月23日
如何从视频或暂停画面里复制文字
字幕、幻灯片、报错信息和视频里的代码都是文字。暂停到那一帧、框选区域、用 OCR 复制出来,不必重新打字。
2026年10月25日
InSnap 如何自动更新(以及怎样手动检查)
后台自动检查、手动检查的菜单项,以及 Windows 安装版与便携版的区别。更新会保留什么,失败了又该怎么办。
2026年10月25日