 InSnap
Por qué el OCR devuelve la palabra equivocada en lugar de un error

El reconocimiento de texto casi nunca avisa de que ha fallado. Devuelve una frase entera con un carácter mal, justo el que importa. Aquí ves dónde pasa y cómo detectarlo.
Copiar texto de una captura suele funcionar, y ese es el problema. Cuando falla, rara vez falla a gritos. No hay subrayado rojo, ni un «no se ha podido reconocer el texto», ni una caja vacía. Hay una frase que se lee perfectamente, salvo por un carácter, y ese carácter cambia el significado.
Por eso la gente pega un número de pedido con un dígito cambiado, una clave de configuración con una letra mal o una frase de un documento con un carácter que nunca estuvo ahí. El reconocimiento no se rompió. Adivinó con confianza.
El reconocimiento es un clasificador, no un analizador sintáctico
Ayuda saber qué hace de verdad el motor. El reconocimiento de texto divide la imagen en líneas, luego en regiones con forma de carácter y después pasa cada región por un clasificador que devuelve el carácter más probable. Ese clasificador nunca dice «no lo sé». Siempre devuelve la coincidencia más cercana que encuentra.
Con una entrada de buena calidad, esa coincidencia más cercana acierta en casi todo. Con mala calidad, la coincidencia más cercana es otro carácter que da la casualidad de parecerse: una a que podría ser una o, un 1 que podría ser una l, o un carácter CJK que se confunde fácilmente con un vecino que comparte un componente. El motor no tiene ni idea de que se equivoca.
Qué hace que la entrada sea «mala»
Importan cuatro cosas, más o menos en este orden:
- Altura del texto en píxeles. Un texto más pequeño tiene menos píxeles que clasificar. Esta es la grande.
- El juego de caracteres. Los caracteres chinos, japoneses y coreanos son densos; unos pocos píxeles perdidos cambian tanto la forma como la identidad del carácter. Las letras latinas son más simples y aguantan más.
- Antialiasing y escalado. Cada redimensionado mezcla los bordes de cada trazo. Un redimensionado va bien; tres, uno encima de otro, pierden la forma.
- Contraste y fondo. Gris sobre blanco y claro sobre oscuro reducen los dos la fuerza de los bordes. Los degradados y las fotos detrás del texto, también.
La mayoría de los avisos de fallo vienen del primero, y la solución suele ser capturar más píxeles, no esforzarse más.
InSnap no tiene un ajuste de precisión aparte. Trabaja sobre los píxeles que seleccionas: una captura 1x de una interfaz densa ya tiene cada línea a la altura con la que la dibujó la pantalla, y una captura Retina 2x tiene el doble. La diferencia entre las dos, para un párrafo de texto dado, es a menudo la diferencia entre correcto y plausible pero equivocado.

Dónde está la frontera práctica
Para ver el límite en vez de adivinarlo, merece la pena montar una prueba pequeña y repetible: renderizar la misma frase a varias alturas de texto, pasar el reconocimiento por cada una y comparar la salida con la entrada carácter a carácter. Es exactamente lo que hacen las dos imágenes de abajo, con salida real de un motor local, no con ejemplos inventados.
La línea en chino y la línea en inglés se renderizaron a cinco alturas y se reconocieron de nuevo cada vez. En rojo, los caracteres que no coinciden con el original.
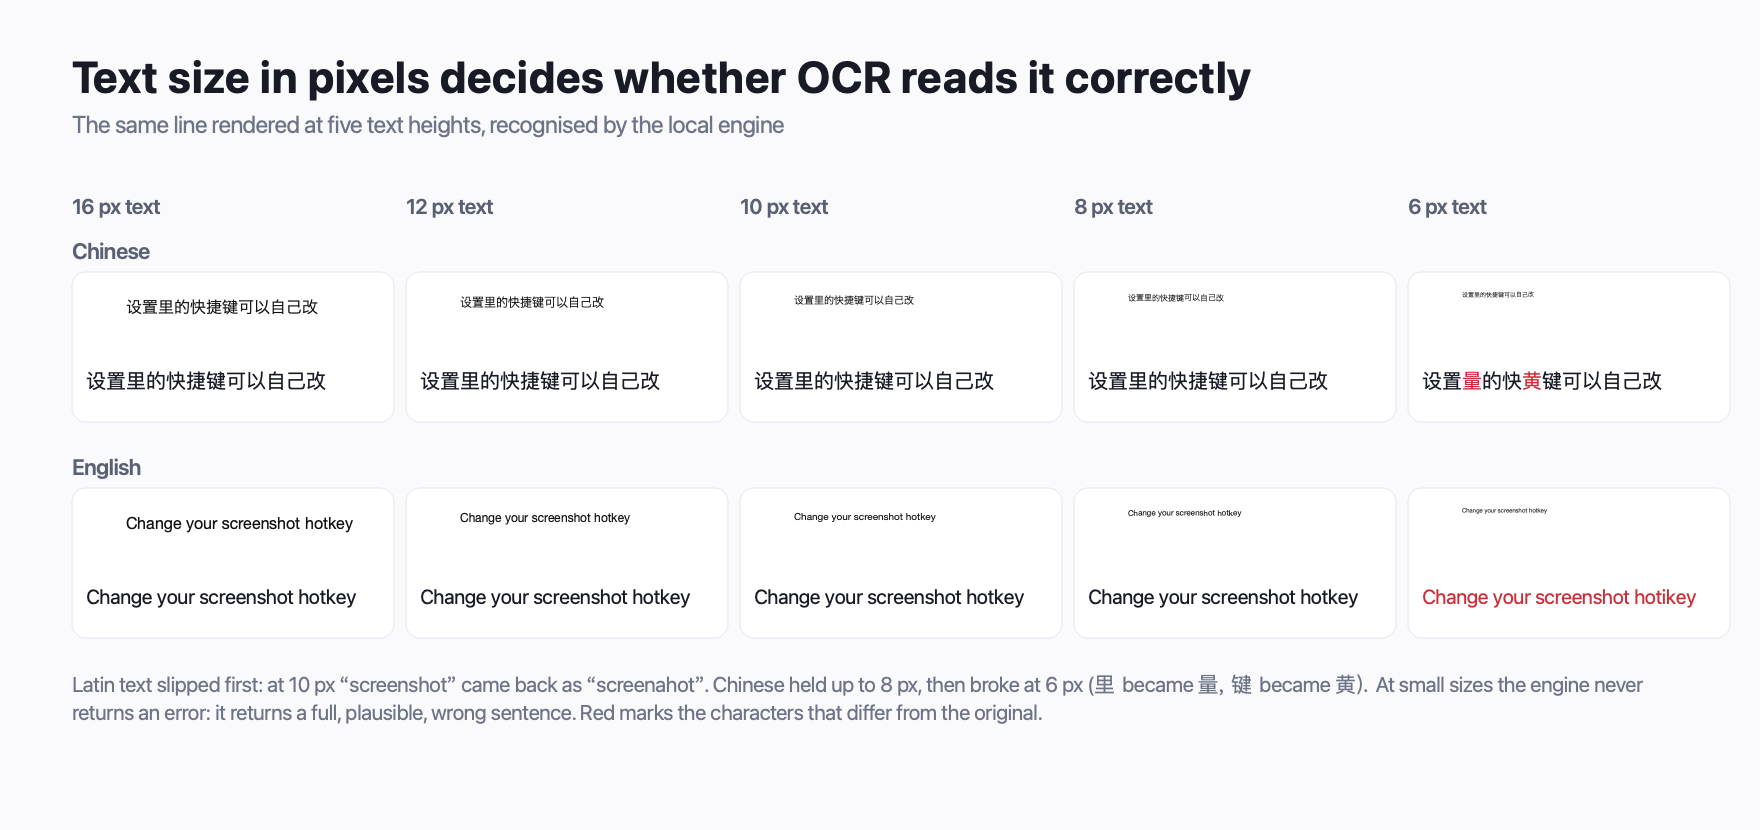
Salen dos cosas. Primero, la línea es correcta hasta que deja de serlo: no hay degradación gradual, solo un tamaño por debajo del cual aparece el carácter equivocado. Segundo, las dos escrituras se rompen en puntos distintos. El texto latino falló antes aquí, mientras que el chino aguantó más, que es lo contrario de lo que la mayoría asume por eso de que «el chino es más difícil».
Cuando la misma frase se reconoce a tamaños aún más pequeños, la salida se vuelve mala de otra manera. Ni vacía ni sin sentido, sino una frase real con caracteres reales y equivocados:
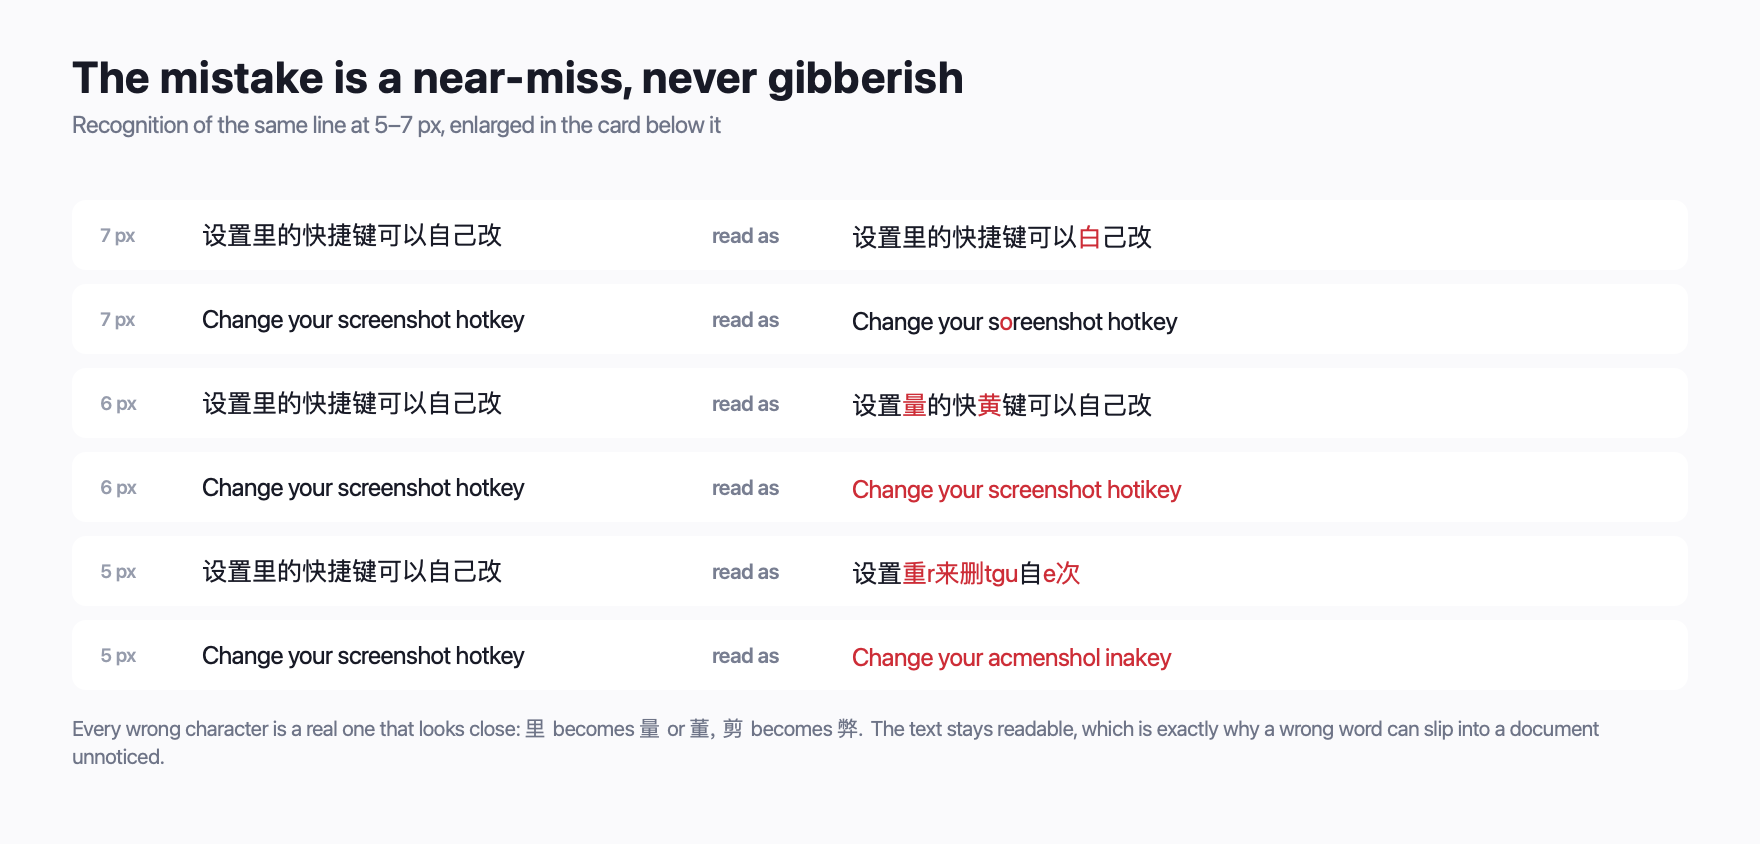
Esa segunda imagen es la útil. Muestra cómo es de verdad un resultado equivocado: ni lo bastante obvio para darte cuenta, ni lo bastante sutil para no ser nada.
Cómo detectarlo antes de que llegue a un documento
El reconocimiento no puede decirte que no está seguro, así que tienes que comprobarlo donde un carácter mal sale caro.
- Comprueba todo lo que lleve números o identificadores. IDs de pedido, claves de licencia, cadenas de versión, totales de factura. Un solo dígito mal es invisible en contexto y fatal más adelante.
- Comprueba la longitud. Un identificador de dos caracteres que ha vuelto con tres, o al revés, es una señal fiable de que algo ha fallado.
- Comprueba los caracteres raros. Barras verticales, espacios, espacios de no separación, confusión entre cirílico y latino. Si el texto es código, pegarlo en una vista de ancho fijo los deja a la vista.
- Comprueba los bordes. Los caracteres al principio o al final de una línea son los primeros que se cortan durante la detección. Si una línea termina de golpe, mira los últimos uno o dos caracteres.
- Vuelve a capturar a más tamaño, no escales hacia arriba. Ampliar una línea borrosa no crea detalle y rara vez arregla un carácter equivocado. Volver a capturar la misma zona a 2x, o ampliar la fuente antes de capturar, sí lo hace.
El corolario práctico es que una captura tomada con una selección amplia y buena resolución es más fácil de reconocer que una diminuta recortada al milímetro. Recortar reduce el ruido, pero encoger reduce la información, y la información es lo que come el clasificador.
Con qué puedes contar
El resumen honesto:
| Situación | Normalmente bien | Normalmente no |
|---|---|---|
| Texto en inglés y escritura latina a tamaño normal de interfaz | Sí | — |
| Chino a tamaño normal de interfaz | Sí | — |
| Texto de menos de unos 10 px de alto | — | No |
| Kana japonés, coreano, ruso | — | No |
| Texto sobre una foto o un degradado | A veces | A veces |
| Capturas redimensionadas a lo bruto | — | No |
El reconocimiento local de InSnap va bien con chino, inglés y lenguas de escritura latina, incluidos los caracteres con acento. No es fiable con kana japonés, coreano ni ruso. Eso es una propiedad del modelo incluido, no un ajuste, así que lo honesto con esas escrituras es verificar todo lo que copies.
Preguntas frecuentes
¿El reconocedor de texto me avisa cuando no está seguro?
No. Un clasificador de caracteres siempre devuelve su mejor conjetura, y la interfaz no tiene un indicador de confianza aparte para copiar. Lo prudente es asumir que cualquier carácter que devuelve es el más probable, no uno garantizado.
¿Puedo arreglar un carácter equivocado volviéndolo a ejecutar?
Normalmente no, porque la entrada no ha cambiado y el modelo es determinista con los mismos píxeles. La solución es cambiar la entrada: volver a capturar la misma zona a más tamaño, o ampliar la fuente antes de capturar, y reconocer de nuevo.
¿Por qué funciona en una captura y falla en otra de la misma página?
Casi siempre por el tamaño del texto en píxeles, que depende de la escala de la pantalla y de si la captura fue a 1x o a 2x. La misma página con otro zoom o en otra pantalla puede cruzar el límite de tamaño.
¿Lee texto dentro de imágenes y fotos?
Solo si el texto es grande y claro sobre un fondo liso. El texto sobre una foto, un degradado o una ilustración compleja es donde más a menudo aparecen caracteres equivocados.
¿Necesito conexión a internet para que funcione?
No. El reconocimiento se ejecuta en local, incluido el paso de copiar. No se sube nada y la precisión es la misma sin conexión.
Más del blog

Cómo obtener mejores resultados de OCR en una captura
El OCR depende de los píxeles que recibe. Recorta al texto, mantén la resolución, evita la inclinación y los fondos cargados, y conoce los límites de idioma.
25 de octubre de 2026
Cómo copiar el texto de una captura o imagen en Mac y Windows
Convierte las palabras de una captura en texto que puedas copiar. Opciones integradas en Mac y Windows, y un flujo de OCR local y rápido con InSnap.
23 de octubre de 2026
Cómo copiar el texto de un vídeo o de un fotograma en pausa
Los subtítulos, las diapositivas, los mensajes de error y el código de un vídeo siguen siendo texto. Pausa, captura la zona y usa OCR para copiarlo sin reescribir nada.
25 de octubre de 2026
Cómo se actualiza InSnap (y cómo comprobarlo a mano)
Comprobaciones automáticas, el elemento del menú y la diferencia entre la versión instalada y la portátil de Windows. Qué conserva una actualización y qué hacer si falla.
25 de octubre de 2026