 InSnap
OCR がエラーではなく「違う単語」を返す理由

文字認識は失敗を教えてくれません。1 文字だけ違う、意味の変わる文字が混ざった文を返します。どこで起きるのか、どう見つけるのかを解説します。
スクリーンショットから文字をコピーするのは、たいていうまくいきます。そしてそれが問題です。失敗するときも、大きな音では失敗しません。赤い下線も、「文字を認識できませんでした」も、空のボックスも出ません。出てくるのは、とても自然に読める文——ただし 1 文字だけ違っていて、しかもその 1 文字が意味を変えてしまう文です。
だから人は、1 桁ずれた注文番号を貼り付け、1 文字違う設定キーを貼り付け、文書にはなかった文字が混じった文を貼り付けてしまうのです。認識はクラッシュしていません。自信をもって推測しただけです。
認識はパーサーではなく分類器
エンジンが実際に何をしているかを知っておくと役に立ちます。文字認識は画像を行に分割し、文字の形をした領域に分け、それぞれの領域を分類器に通して、もっとも確からしい文字を返します。その分類器は決して「分からない」とは言いません。いつでも、見つけられるいちばん近い候補を返します。
入力の品質が良ければ、その「いちばん近い候補」はほぼどこでも正しいものです。品質が悪いと、その候補はたまたま似て見える別の文字になります。a が o に見える、1 が l に見える、あるいは同じ構成要素を共有する隣の漢字と取り違える、といった具合です。エンジン自身は、自分が間違っているとはまったく思っていません。
入力が「悪い」とはどういうことか
重要なのは 4 つで、おおよそ次の順です。
- 文字の高さ(ピクセル数)。 小さい文字は分類に使えるピクセルが少なくなります。これが最大の要因です。
- 文字集合。 中国語、日本語、韓国語の文字は情報が密で、数ピクセル失われるだけで形も文字の同一性も変わります。ラテン文字は単純で、より長く耐えます。
- アンチエイリアスと拡大縮小。 サイズ変更のたびに、すべてのストロークの縁が混ざります。1 回なら問題ありませんが、3 回重なると形が失われます。
- コントラストと背景。 白地にグレー、暗い地に明るい文字は、どちらも縁の強さを下げます。文字の後ろのグラデーションや写真も同じです。
失敗報告の多くは 1 番目から来ていて、解決策はたいてい「もっとピクセルを取る」ことで、気合を入れて読み直すことではありません。
InSnap に精度の設定はありません。選んだピクセルに対して動くだけです。密な UI の 1x スクリーンショットでも、各行は画面が描いたその高さで入っており、2x の Retina キャプチャならその 2 倍になります。同じ段落にとって、この 2 つの差は、しばしば「正しい」と「もっともらしいが間違い」の差になります。

実際の境界線はどこにあるか
当てずっぽうではなく境界を見るには、小さくて繰り返せるテストを作る価値があります。同じ文をいくつかの文字の高さで描画し、それぞれで認識をかけ、出力を入力と 1 文字ずつ比べるのです。下の 2 枚の画像はまさにそれで、作り話ではなく、ローカルのエンジンが実際に出した結果を使っています。
中国語の行と英語の行を 5 つの高さで描画し、そのたびに新しく認識させました。赤は、元と違った文字を示しています。
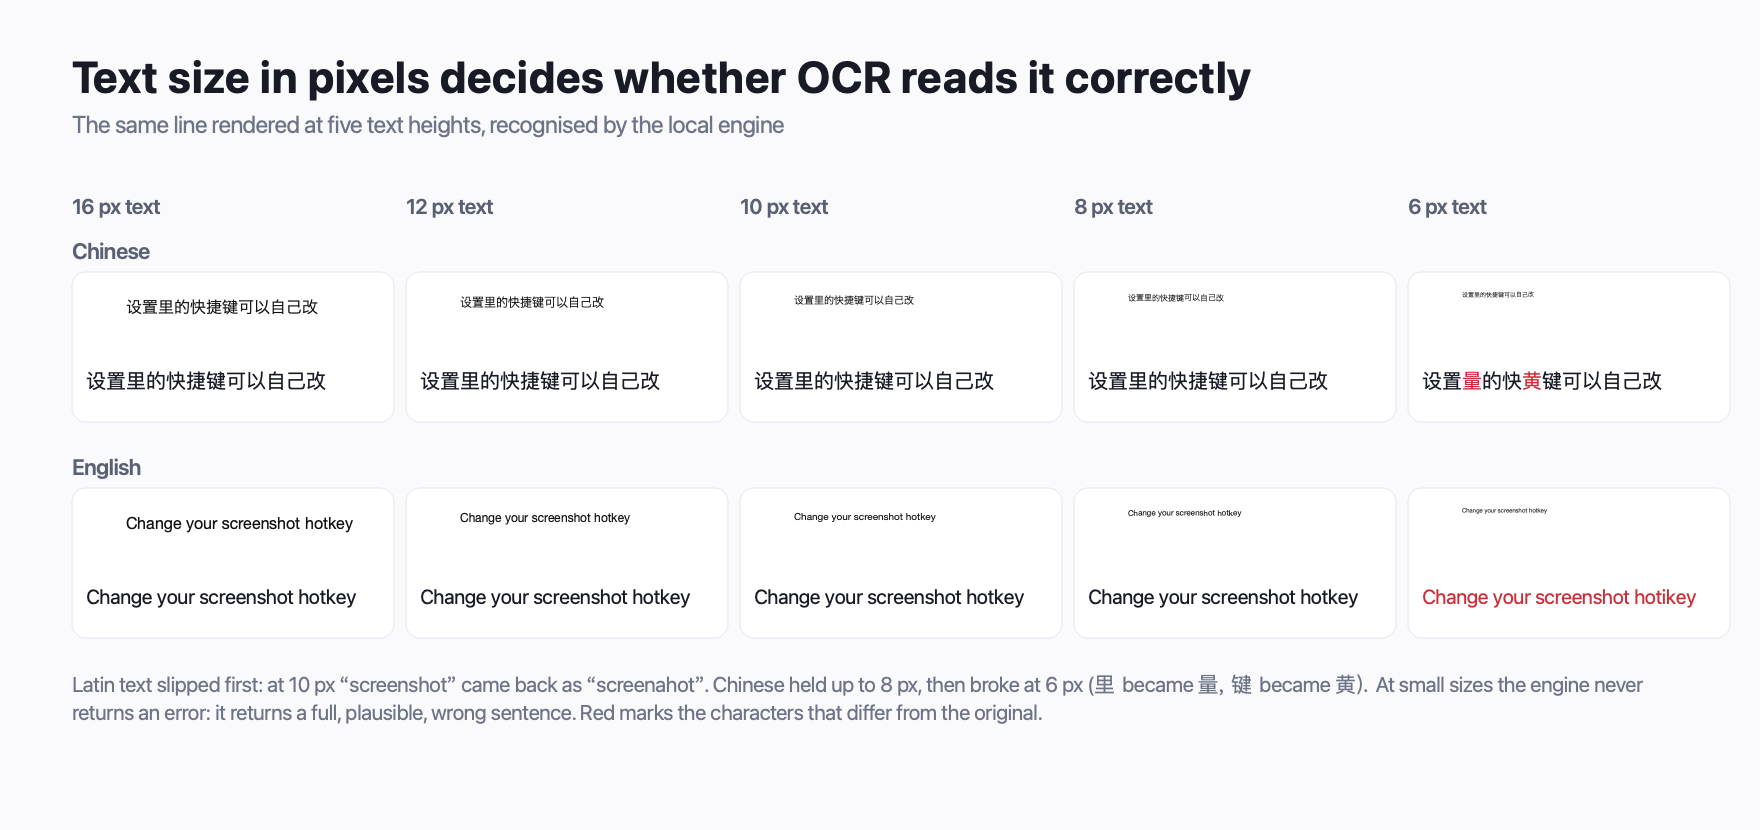
ここから 2 つのことが分かります。1 つ目は、正しい行はあるところから突然正しくなくなるということです。なだらかに劣化するのではなく、あるサイズを下回ると違う文字が現れます。2 つ目は、2 つの文字体系が別のポイントで崩れるということです。ここではラテン文字のほうが早く滑り、中国語のほうが長く持ちこたえました。「中国語のほうが難しい」という多くの人の思い込みとは逆です。
さらに小さいサイズで同じ文を認識させると、出力は別の種類の間違いになります。空でも、意味不明の文字列でもなく、本物の単語でできた、本物だが間違った文です。
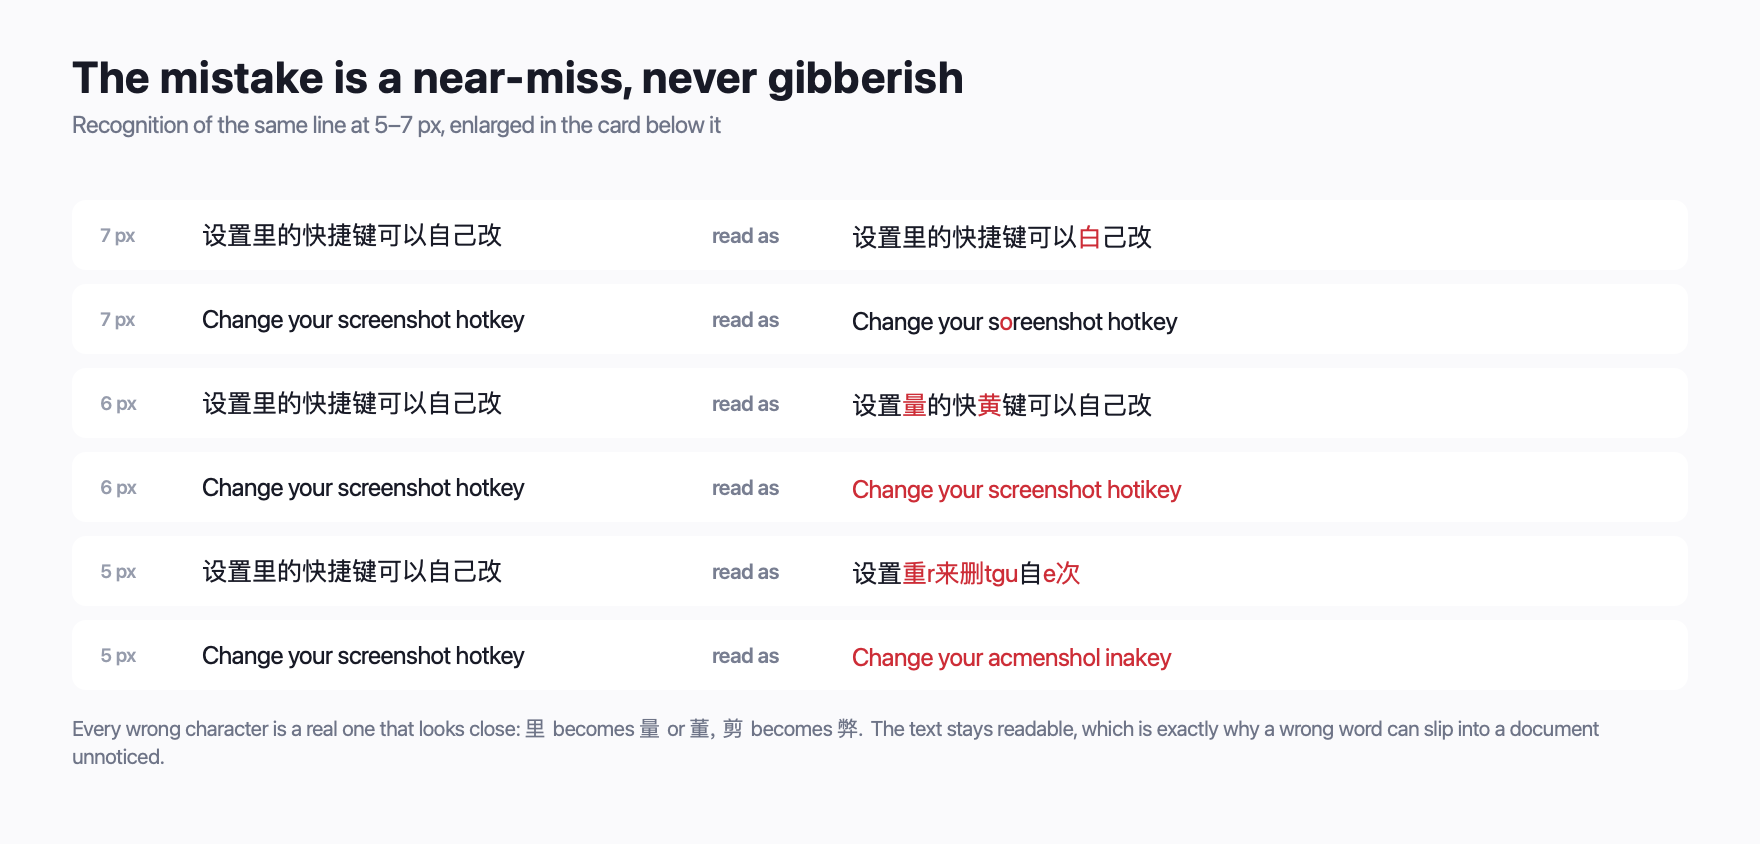
2 枚目の画像のほうが役に立ちます。間違った結果が実際にどう見えるかを示しているからです。気づくほど明らかではなく、無視できるほど微妙でもない、という状態です。
文書に入る前に見つける方法
認識は「自信がない」とは言えないので、違う 1 文字が高くつく場面では自分で確認するしかありません。
- 数字や識別子を含むものは確認する。 注文 ID、ライセンスキー、バージョン文字列、請求書の合計額。1 桁の誤りは文脈の中では見えず、下流では致命的です。
- 長さを確認する。 2 文字の識別子が 3 文字で返ってきた、あるいはその逆なら、何かがおかしいという確実なサインです。
- 変わった文字を確認する。 縦棒、スペース、改行しないスペース、キリル文字とラテン文字の混同など。コードなら、等幅表示に貼り付けるとすぐ分かります。
- 端を確認する。 行の最初や最後の文字は、検出のときに最初に切られます。行が不自然に終わっていたら、最後の 1〜2 文字を見てください。
- 大きく撮り直す。拡大しない。 ぼやけた行を拡大しても細部は生まれず、違う文字が直ることもほとんどありません。同じ範囲を 2x で撮り直すか、撮る前に元をズームすれば直ります。
実用的な帰結として、良い解像度で広めに撮ったスクリーンショットのほうが、きつく切り抜いた小さなものより認識しやすいです。切り抜きはノイズを減らしますが、縮小は情報を減らします。そして分類器が食べるのは情報です。
信頼してよいこと
正直なまとめです。
| 状況 | たいてい大丈夫 | たいてい無理 |
|---|---|---|
| 通常の UI サイズの英語・ラテン文字 | はい | — |
| 通常の UI サイズの中国語 | はい | — |
| おおよそ 10 px 未満の文字 | — | いいえ |
| 日本語のかな、韓国語、ロシア語 | — | いいえ |
| 写真やグラデーション上の文字 | ときどき | ときどき |
| 大きくサイズ変更したスクリーンショット | — | いいえ |
InSnap のローカル認識は、アクセント記号を含む中国語、英語、ラテン文字の言語を得意とします。日本語のかな、韓国語、ロシア語は確実ではありません。これは設定ではなく同梱モデルの性質なので、これらの文字体系では、コピーした内容を必ず確認するのが正直な対応です。
よくある質問
認識に自信がないとき、教えてくれますか?
いいえ。文字の分類器は必ず最良の推測を返し、コピーのための別個の信頼度表示はありません。返ってきた文字は「もっともありそうな文字」であって「保証された文字」ではない、と考えるのが安全です。
もう一度実行すれば違う文字は直りますか?
たいてい直りません。入力が変わっておらず、同じピクセルに対してモデルは決定的だからです。直すには入力を変えます。同じ領域を大きなサイズで撮り直すか、撮る前に元をズームしてから、もう一度認識させてください。
同じページなのに、あるスクリーンショットでは成功し、別のでは失敗するのはなぜですか?
ほとんどはピクセル単位の文字サイズで、これはディスプレイのスケーリングと、1x か 2x かで決まります。同じページでもズームやディスプレイが違えば、サイズの境界線をまたぐことがあります。
画像や写真の中の文字も読めますか?
文字が大きく鮮明で、背景が平坦な場合だけです。写真、グラデーション、複雑なイラストの上の文字は、違う文字がもっとも出やすい場所です。
動かすのにインターネット接続は必要ですか?
いいえ。認識はコピーの工程も含めてローカルで動きます。何もアップロードされず、オフラインでも精度は同じです。
ブログのほかの記事

スクリーンショットの OCR 精度を上げるコツ
文字認識の精度は、渡すピクセルの質で決まります。きつく切り抜き、解像度を保ち、傾きや背景のノイズを避け、対応言語の限界を知っておくことが大切です。
2026年10月25日
スクリーンショットや画像から文字をコピーする方法(Mac・Windows)
スクリーンショットや画像の中の文字を、コピーできるテキストに変える方法。Mac と Windows の標準機能に加え、InSnap で撮ってすぐ OCR する手順も紹介します。
2026年10月23日
動画や一時停止したフレームから文字をコピーする方法
動画の中の字幕、スライド、エラー表示、コードも文字です。フレームで一時停止して範囲をキャプチャし、OCR でコピーする手順と、認識が苦手な条件を説明します。
2026年10月25日
InSnap の自動アップデートと手動での確認方法
macOS と Windows の自動チェック、手動のアップデート確認、インストール版とポータブル版の違い、更新で残るデータをまとめます。
2026年10月25日