 InSnap
11개 언어로 본 스크린샷 OCR: 되는 언어와 안 되는 언어

오프라인 OCR을 인터페이스 언어 11개로 시험했습니다. 영어, 중국어, 라틴 문자 언어는 거의 완벽했고, 일본어, 한국어, 러시아어는 실패했습니다. 수치를 공개합니다.
InSnap의 오프라인 OCR은 테스트한 인터페이스 언어 11개 중 8개를 거의 완벽하게 읽었고, 일본어, 한국어, 러시아어 3개에서는 실패했습니다. 같은 방식으로 테스트한 Apple의 텍스트 인식 API는 11개 언어를 모두 98% 이상으로 읽었습니다.
그래서 "스크린샷 OCR이 내 언어에서 되나요?"라는 질문의 답은 예 아니면 아니요가 아닙니다. 문자 체계에 따라 다르며, 그 차이가 커서 복사한 내용을 믿기 전에 확인할 가치가 있습니다.
테스트 방법
각 언어마다 InSnap 자체 인터페이스의 실제 문장 여섯 개를 그 언어의 번역본으로 가져와, 시스템 UI 글꼴의 일반 크기로 렌더링했습니다. 내용을 정확히 알고 있는 깨끗한 시험 시트가 나온 셈입니다. 시트는 Retina(2x)와 1x 두 가지로 만들었습니다.
두 엔진이 모든 시트를 읽었습니다.
- InSnap OCR: 번들된 모델로 컴퓨터에서 완전히 실행되며, Mac과 Windows에서 동일합니다.
- Apple Vision 텍스트 인식: macOS에 내장된 인식 API입니다. 정확도 모드에서 언어를 자동 감지하도록 설정했습니다. 특정 앱이 아니라 API 자체를 직접 테스트했습니다.
점수는 인식된 텍스트와 실제 문장 사이의 평균 유사도입니다. 공백과 대소문자는 무시했습니다. 100%는 모든 문장이 정확히 그대로 나왔다는 뜻입니다.
결과
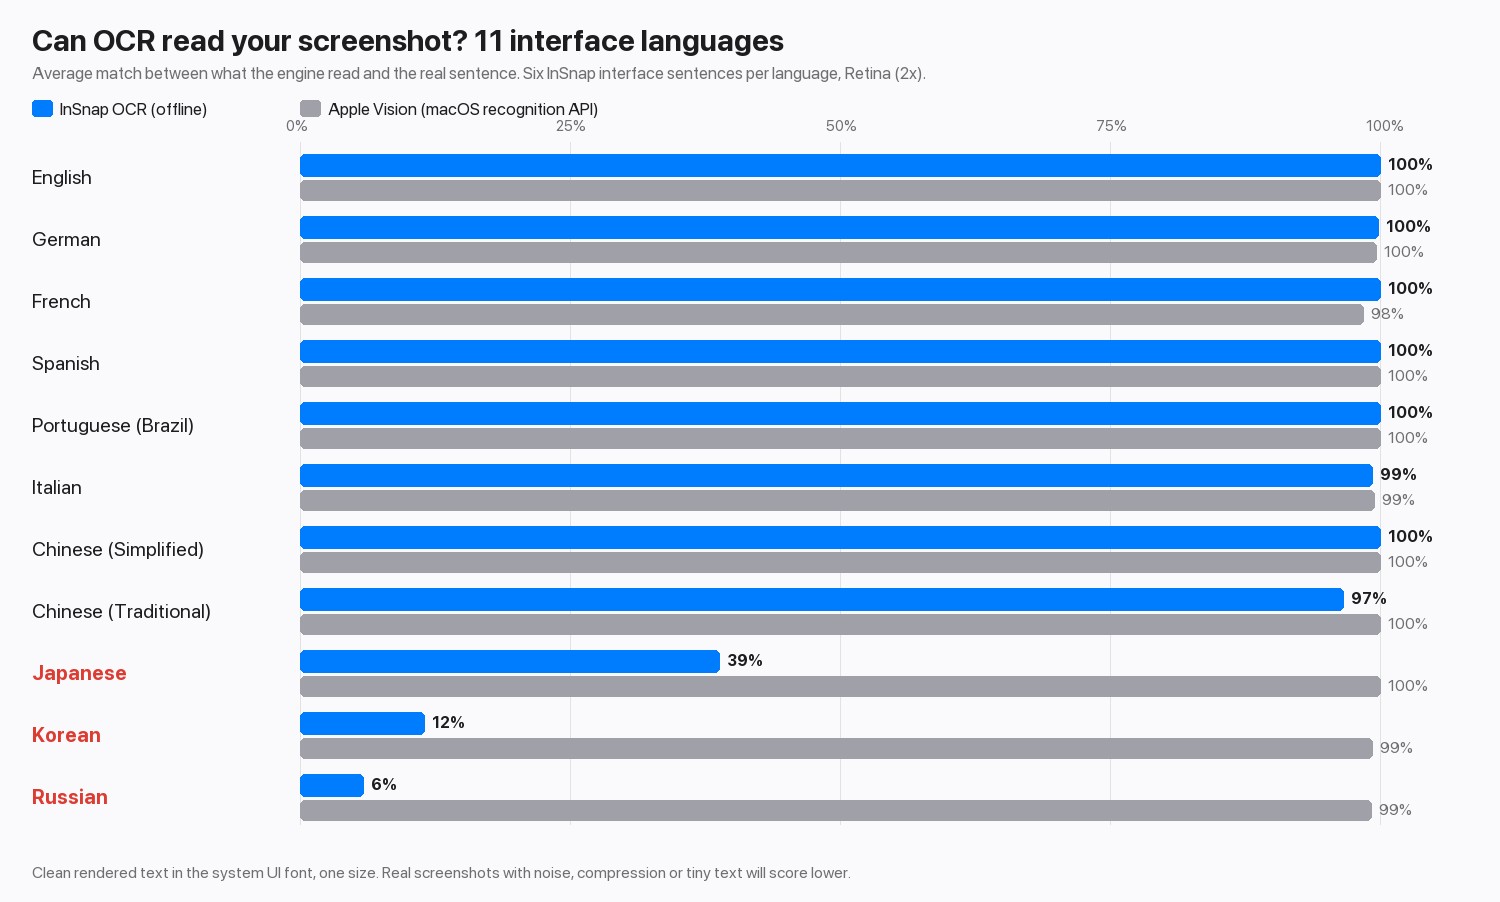
| 언어 | InSnap OCR | Apple Vision |
|---|---|---|
| 영어, 독일어, 스페인어, 포르투갈어 | 100% | 100% |
| 프랑스어 | 100% | 98% |
| 이탈리아어 | 99% | 99% |
| 중국어(간체) | 100% | 100% |
| 중국어(번체) | 97% | 100% |
| 일본어 | 39% | 100% |
| 한국어 | 12% | 99% |
| 러시아어 | 6% | 99% |
Retina 시트와 1x 시트의 점수는 1점 이내로 비슷했습니다. 해상도 문제가 아니었습니다.
실패는 어떻게 보이는가
약한 세 언어는 잘못 읽히는 정도가 아니라 전혀 다른 무언가로 읽힙니다. 독자가 완벽하게 명확한 텍스트로 보는 테스트 문장 하나를 예로 들겠습니다.
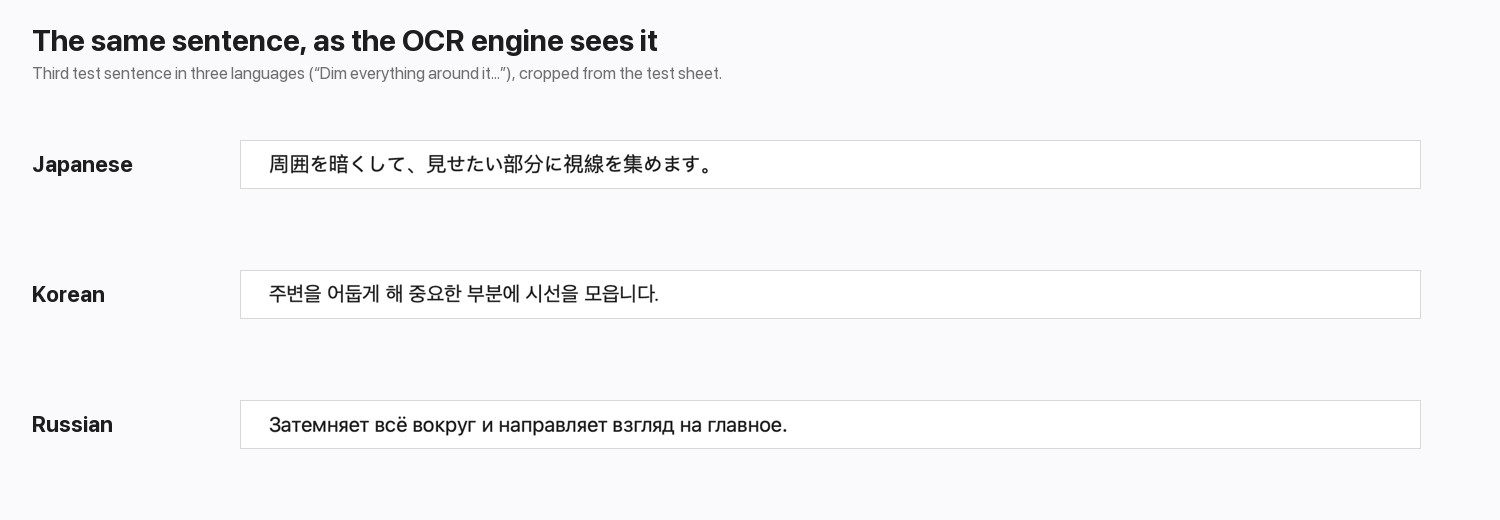
| 언어 | 실제 텍스트 | InSnap OCR 결과 |
|---|---|---|
| 일본어 | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| 한국어 | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| 러시아어 | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
일본어는 한자를 유지하지만 많은 가나를 비슷하게 생긴 한자로 바꿉니다. 한국어는 한자, 숫자, 문장 부호가 뒤섞인 결과로 나옵니다. 러시아어는 키릴 문자와 비슷하게 생긴 라틴 문자와 숫자로 읽힙니다. 세 경우 모두 결과가 텍스트처럼 보여서 아무런 경고가 없습니다. (이 표에서 한국어 결과는 줄여서 표시했습니다.) 중국어 번체는 대부분 괜찮지만, 몇몇 글자가 간체 형태로 나왔으니 이름과 인용문은 교정하세요.
여러분에게 의미하는 바
- 영어, 중국어, 라틴 문자 언어: 깨끗한 텍스트에서는 InSnap이 정확합니다. 그래도 숫자와 고유명사는 확인하세요. OCR 결과를 더 좋게 얻는 방법을 참고하세요.
- 일본어, 한국어, 러시아어: 결과를 한 줄씩 확인하지 않고는 InSnap의 OCR에서 복사하지 마세요. 우리 테스트에서 Apple의 인식 API는 세 언어를 모두 처리했으므로, Mac에서는 이런 문자 체계에 대해 그 API를 쓰는 도구가 더 나은 선택입니다. Windows에 내장된 인식은 테스트하지 않았습니다.
- 섞인 텍스트: 가능하면 한 번에 한 문자 체계만 선택하세요.
InSnap은 Mac과 Windows에서 같은 번들 모델을 사용하므로 결과가 어느 쪽에서든 같고, 아무것도 업로드되지 않습니다. 대신 언어 범위는 그 모델이 정한 대로 고정됩니다.
테스트가 보여 주지 않는 것
- 깨끗한 텍스트만 다뤘습니다. 실제 스크린샷에는 압축, 작은 크기, 복잡한 배경이 있으며, 모든 엔진이 그런 조건에서 점수가 더 낮습니다.
- 언어당 여섯 문장. 60~90점 차이를 보여 주기에는 충분하지만, 둘 다 97%를 넘는 두 엔진의 순위를 매기기에는 부족합니다.
- 글꼴과 크기 하나. 장식 글꼴과 손글씨는 어떤 엔진에게도 더 어렵습니다.
자주 묻는 질문
InSnap의 OCR은 어떤 언어를 읽을 수 있나요?
우리 테스트에서는 영어, 독일어, 프랑스어, 스페인어, 포르투갈어, 이탈리아어, 중국어(간체와 번체)를 97% 이상으로 읽었습니다. 일본어, 한국어, 러시아어는 읽을 수 없었습니다.
러시아어 텍스트가 왜 라틴 문자로 나오나요?
인식 모델은 키릴 문자를 읽도록 만들어지지 않았기 때문에, 알고 있는 것 중 가장 가까운 모양을 고릅니다. 많은 키릴 문자가 라틴 문자나 숫자처럼 보여서, 결과가 깨진 영어처럼 보이는 것입니다.
스크린샷을 더 크게 하거나 해상도를 높이면 도움이 되나요?
여기서는 그렇지 않습니다. Retina 시트와 1x 시트의 점수는 1점 이내로 비슷했습니다. 한계는 이미지 품질이 아니라 모델의 언어 범위에 있습니다.
운영체제에 내장된 OCR이 더 정확한가요?
일본어, 한국어, 러시아어에서는 그렇습니다. 우리 테스트에서 Apple Vision API는 세 언어를 모두 99% 이상으로 읽었습니다. 영어, 중국어, 라틴 문자 언어에서는 두 엔진이 몇 점 차이로 비슷했습니다.
블로그의 다른 글

OCR이 오류 대신 틀린 단어를 돌려주는 이유
문자 인식은 실패했다고 거의 말하지 않습니다. 중요한 한 글자만 틀린 문장을 그대로 돌려주죠. 어디서 일어나는지, 어떻게 잡아내는지 정리했습니다.
2026년 10월 29일
스크린샷·이미지에서 텍스트 복사하는 방법 (Mac, Windows)
스크린샷 속 글자를 복사할 수 있는 텍스트로 바꾸는 방법. Mac과 Windows 기본 기능부터 InSnap의 빠른 온디바이스 OCR 워크플로까지 정리했습니다.
2026년 10월 23일
스크린샷 OCR 인식률 높이는 방법
텍스트 인식은 넣어 주는 픽셀만큼만 정확합니다. 타이트하게 자르고 해상도를 지키며 기울기와 복잡한 배경을 피하고, 언어 한계를 아는 요령을 정리했습니다.
2026년 10월 25일
스크린샷 용량이 커서 업로드가 안 될 때 줄이는 방법
Retina 화면 전체를 캡처한 PNG는 몇 MB에 달하기도 해요. 용량이 어디서 나오는지, 글자를 흐리게 만들지 않고 배율·형식·자르기로 줄이는 설정을 정리했어요.
2026년 10월 30일