 InSnap
11 種語言的截圖 OCR:哪些能用、哪些不行

我們用 11 種介面語言測試離線 OCR。英文、中文與拉丁字母語言幾乎完全正確;日文、韓文與俄文則失敗。數據如下。
InSnap 的離線 OCR 在我們測試的 11 種介面語言中,有 8 種讀得幾乎完美,但在 3 種上失敗:日文、韓文與俄文。Apple 的文字辨識 API 以同樣方式測試,11 種語言全部達到 98% 以上。
所以「我的語言適不適合截圖 OCR」這個問題,答案不是簡單的是或否。它取決於文字系統(script),而且落差大到值得在依賴複製的結果之前先檢查。
測試方式
對每種語言,我們從 InSnap 自己的介面中取出六個真實句子,使用該語言的譯文,並以系統介面字型、一般大小渲染。這樣就得到一張乾淨、文字完全已知的測試圖。每張測試圖都做了 Retina(2x)與 1x 兩種版本。
兩套辨識引擎讀取了每張測試圖:
- InSnap 的 OCR,完全在你的電腦上執行,使用內建模型,Mac 與 Windows 上的結果相同。
- Apple Vision 文字辨識,即 macOS 內建的辨識 API,使用精確模式並自動偵測語言。我們是直接測試這個 API,而不是測試使用它的某個 App。
分數是引擎讀到的文字與真實句子之間的平均相似度,計算時忽略空白與大小寫。100% 代表每個句子都完全正確讀出。
結果
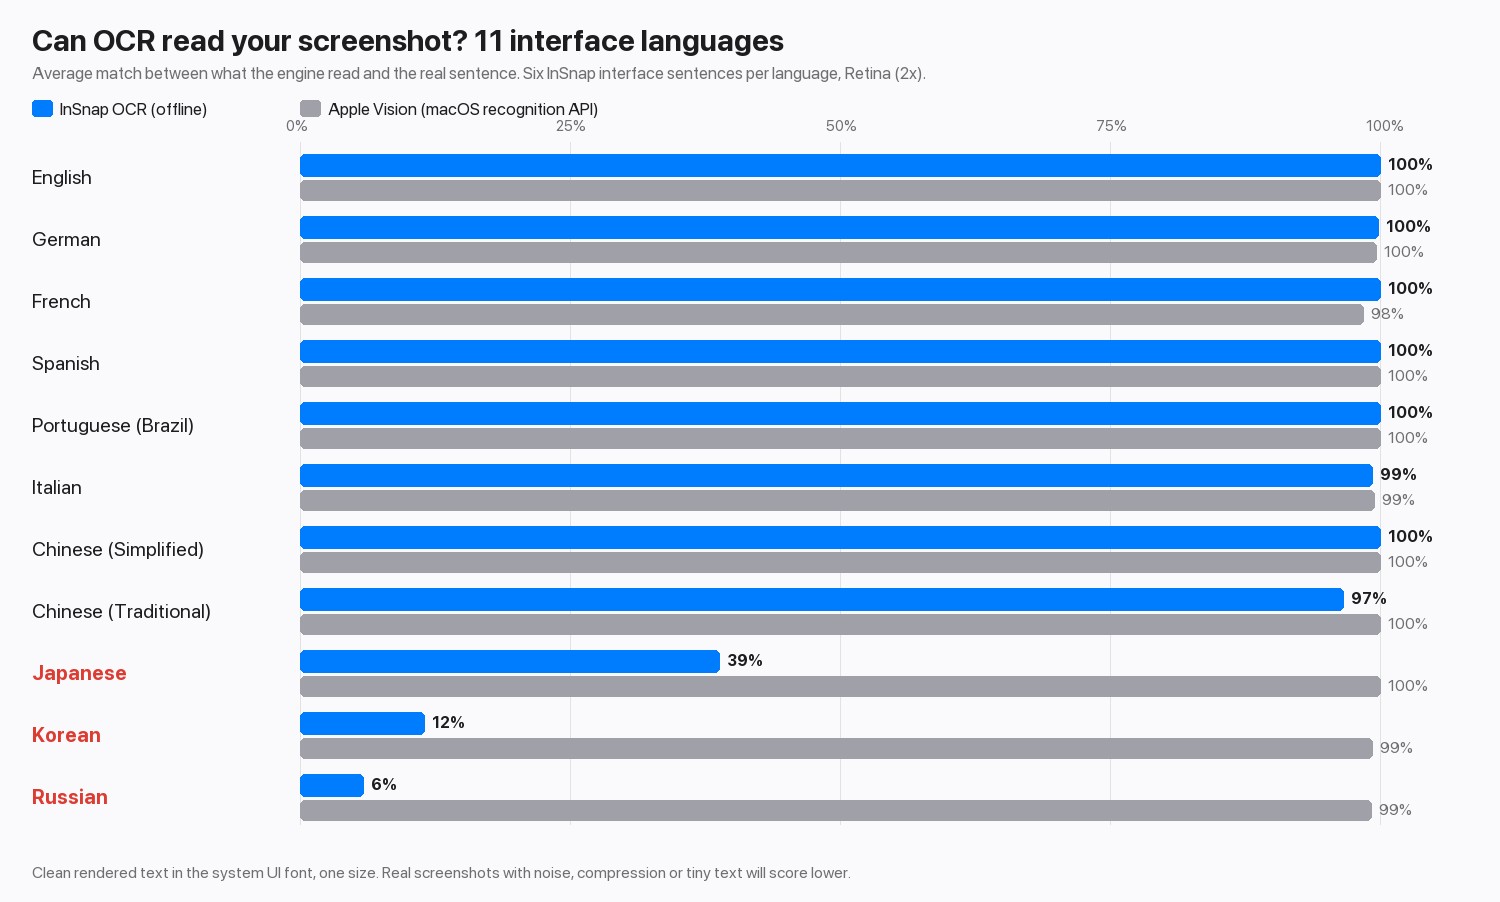
| 語言 | InSnap OCR | Apple Vision |
|---|---|---|
| 英文、德文、西班牙文、葡萄牙文 | 100% | 100% |
| 法文 | 100% | 98% |
| 義大利文 | 99% | 99% |
| 簡體中文 | 100% | 100% |
| 繁體中文 | 97% | 100% |
| 日文 | 39% | 100% |
| 韓文 | 12% | 99% |
| 俄文 | 6% | 99% |
Retina 與 1x 測試圖的分數相差不到一分,所以解析度不是問題所在。
失敗長什麼樣子
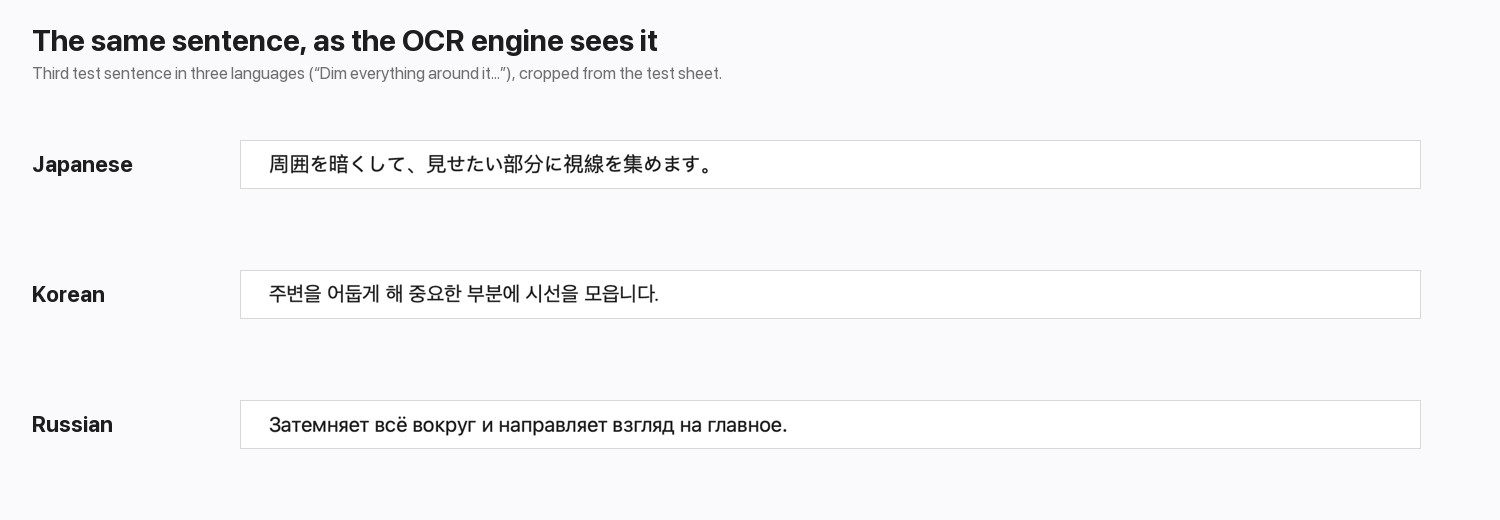
這三種較弱的語言不是被讀得不好,而是被讀成了別的東西。以下是其中一個測試句子,人類讀者看來是完全清楚的文字:
| 語言 | 真實文字 | InSnap OCR 回傳的結果 |
|---|---|---|
| 日文 | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| 韓文 | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| 俄文 | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
日文保留了漢字,但把許多假名換成了外形相似的漢字。韓文會被讀成中文字、數字與標點的混合。俄文會被讀成拉丁字母與數字,它們的外形與西里爾字母相近。這三種情況的輸出看起來都像文字,所以不會有任何警示。(此處的韓文輸出有所縮短。)繁體中文大致沒問題,但有少數字被辨識成簡體字,所以校對人名與引文時請多加留意。
這對你代表什麼
- 英文、中文與拉丁字母語言: 在乾淨的文字上,InSnap 相當準確。不過數字與專有名詞仍要再檢查;參見如何讓截圖的 OCR 辨識結果更準確。
- 日文、韓文與俄文: 從 InSnap 的 OCR 複製之前,請逐行檢查。在我們的測試中,Apple 的辨識 API 三種都處理得很好,所以在 Mac 上,使用該 API 的工具是這些文字系統的較佳選擇。我們沒有測試 Windows 內建的辨識功能。
- 混合文字: 能的話,每次只選取一種文字系統。
InSnap 在 Mac 與 Windows 上使用同一個內建模型,所以兩邊的結果相同,而且不會上傳任何內容。取捨是:它的語言涵蓋範圍受限於該模型。
這項測試沒有涵蓋的範圍
- 只測了乾淨的文字。 真實截圖常帶有壓縮、小字級與雜亂的背景,每個引擎在這些情況下的分數都會更低。
- 每種語言只有六個句子。 足以顯示 60 到 90 分的落差,但不足以為兩個都超過 97% 的引擎排出名次。
- 只用一種字型與字級。 花俏字型與手寫字對任何引擎來說都更難辨識。
常見問題
InSnap 的 OCR 能辨識哪些語言?
在我們的測試中,它能以 97% 或以上的準確度讀取英文、德文、法文、西班牙文、葡萄牙文、義大利文,以及中文(簡體與繁體)。日文、韓文與俄文無法讀取。
為什麼俄文會被辨識成拉丁字母?
辨識模型並不是為了讀西里爾字母而建立的,所以它會挑選自己所知道的、最接近的字形。許多西里爾字母看起來很像拉丁字母或數字,這就是輸出看起來像亂碼英文的原因。
放大截圖或提高解析度有幫助嗎?
在這裡沒有幫助。Retina 與 1x 測試圖的分數相差不到一分。限制來自模型的語言涵蓋範圍,而不是圖片品質。
作業系統內建的 OCR 比較準確嗎?
就日文、韓文與俄文而言,是的:在我們的測試中,Apple 的 Vision API 三種都讀到 99% 或以上。就英文、中文與拉丁字母語言而言,兩者的差距在幾個百分點之內,基本相當。
部落格的更多文章

為什麼 OCR 會直接給你錯字,而不是報錯
文字辨識很少承認自己失敗。它會交回一整句看起來完全通順的話,只是錯了一個字——偏偏就是關鍵的那一個。本文說明它發生在哪裡、又該怎麼抓出來。
2026年10月29日
如何在 Mac 與 Windows 上複製截圖或圖片中的文字
把截圖裡的文字變成可以複製的文字。包含 Mac 與 Windows 的內建做法,以及用 InSnap 在本機快速完成 OCR 的流程。
2026年10月23日
如何讓截圖的 OCR 辨識結果更準確
文字辨識的品質取決於你餵給它多少像素。框緊文字、保留解析度、避開傾斜與雜亂背景,並認清語言限制。
2026年10月25日
截圖檔案太大無法上傳?原因與縮小的方法
全螢幕 Retina PNG 動輒好幾 MB。這篇說明檔案大小從哪裡來,以及用縮放、格式與裁切設定把它變小、又不會讓文字變模糊的做法。
2026年10月30日