 InSnap
11 种语言的截图 OCR:哪些能用,哪些不能

我们在 11 种界面语言上测试了离线 OCR。英文、中文和拉丁字母语言几乎完全正确;日文、韩文和俄文没能读准。数据都在这里。
InSnap 的离线 OCR 在我们测试的 11 种界面语言中,有 8 种读得几乎完美,另外 3 种没能读准:日文、韩文和俄文。同样方法测试的 Apple Vision 文字识别接口,11 种语言都读到了 98% 或以上。
所以,「截图 OCR 能不能用在我的语言上」并不是一个是或否的问题。它取决于文字的书写系统,而且差距大到值得在依赖识别结果之前先检查一下。
测试方法
每种语言,我们都从 InSnap 自己的界面里取了六句真实文字,使用该语言的译文,用系统界面字体按正常字号渲染。这样就得到一张文字完全已知的干净测试图。每张测试图都做了 Retina(2x)和 1x 两个版本。
两种引擎读了每一张测试图:
- InSnap 的 OCR:完全在你的电脑上运行,使用随应用附带的模型,在 Mac 和 Windows 上完全一致。
- Apple Vision 文字识别:macOS 内置的识别接口,使用精确模式并自动检测语言。我们直接测试的是这个接口,而不是用到它的某个具体应用。
分数是引擎读出的文字与真实句子之间的平均相似度,计算时忽略空格和大小写。100% 表示每一句都原样读出。
结果
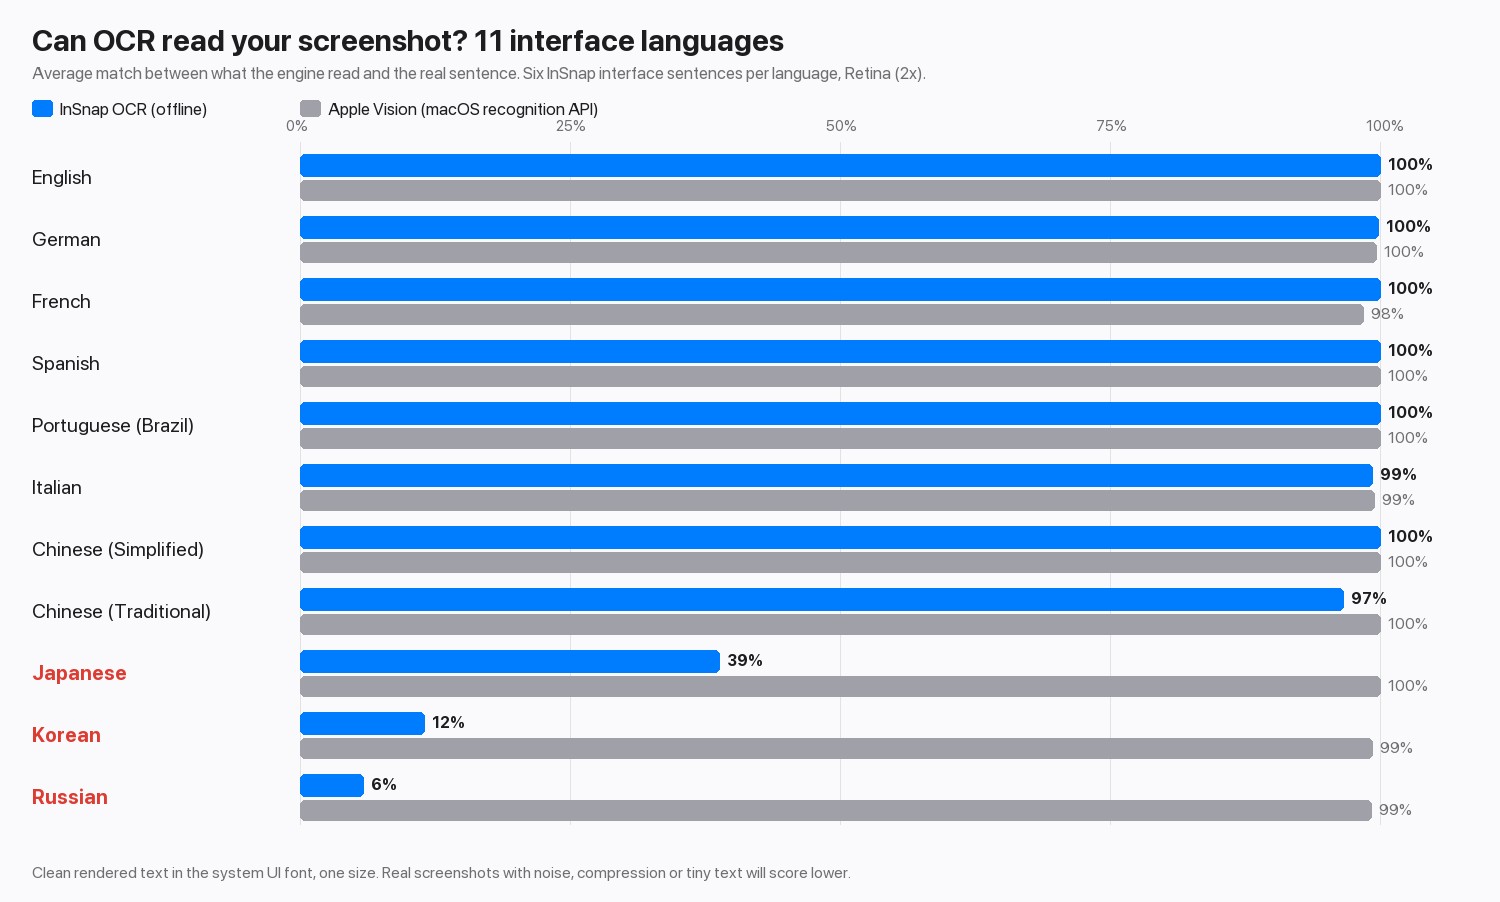
| 语言 | InSnap OCR | Apple Vision |
|---|---|---|
| 英语、德语、西班牙语、葡萄牙语 | 100% | 100% |
| 法语 | 100% | 98% |
| 意大利语 | 99% | 99% |
| 中文(简体) | 100% | 100% |
| 中文(繁体) | 97% | 100% |
| 日语 | 39% | 100% |
| 韩语 | 12% | 99% |
| 俄语 | 6% | 99% |
Retina 和 1x 两版测试图的得分相差不到 1 个百分点,所以问题不在分辨率。
失败是什么样子
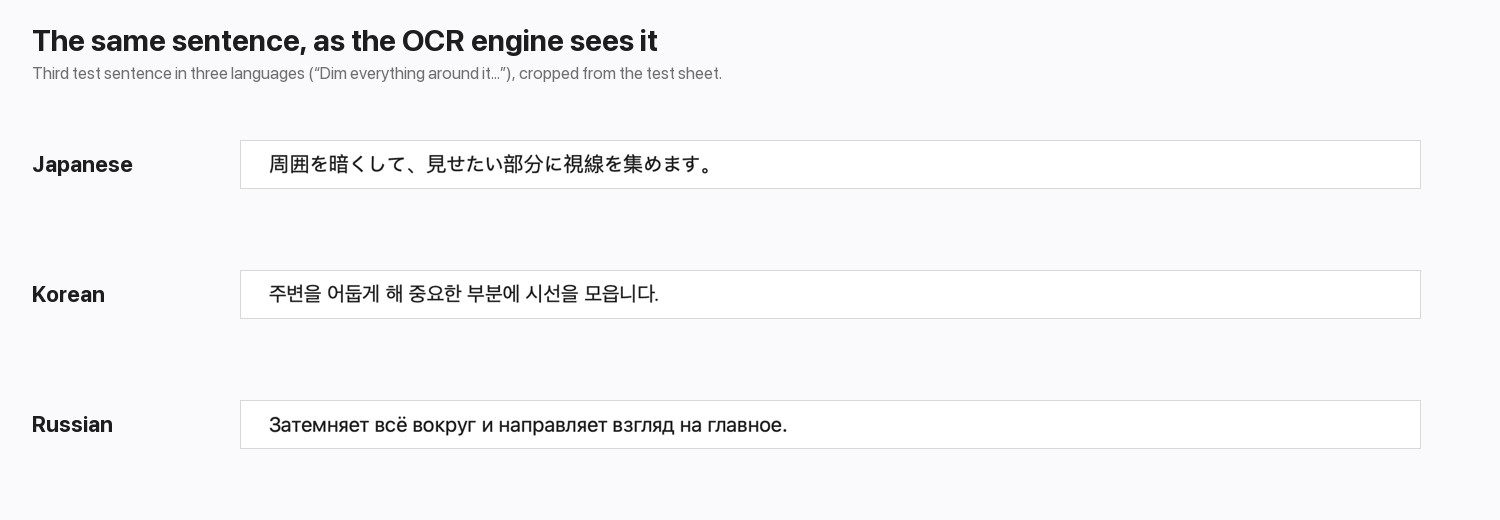
这三种弱势语言不是读得差,而是被读成了别的东西。下面是其中一句测试文字,人看起来它再清楚不过:
| 语言 | 真实文字 | InSnap OCR 的输出 |
|---|---|---|
| 日语 | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| 韩语 | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| 俄语 | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
日语保留了汉字,但把很多假名换成了形似的汉字。韩语的结果是汉字、数字和标点的混合。俄语被读成了拉丁字母和数字,它们长得像西里尔字母。三种情况下,输出看起来都像文字,所以不会有任何提醒。(这里韩语的输出做了省略。)繁体中文基本没问题,但有几个字被读成了简体字,所以名字和引文要仔细校对。
这对你意味着什么
- 英语、中文和拉丁字母语言: 在干净的文字上,InSnap 很准确。数字和专有名词仍然要核对;参见如何让截图的 OCR 识别结果更准确。
- 日语、韩语和俄语: 不要不逐行检查就直接复制 InSnap 的 OCR 结果。在我们的测试中,Apple Vision 接口三种都处理得很好,所以在 Mac 上,用到它的工具对这些文字是更合适的选择。我们没有测试 Windows 自带的识别功能。
- 混合文字: 能的话,尽量一次只框选一种文字。
InSnap 在 Mac 和 Windows 上使用同一个随附模型,所以两边结果相同,而且不会上传任何内容。代价是它的语言覆盖范围由这个模型决定。
这次测试没有说明什么
- 只测了干净的文字。 真实截图往往带有压缩痕迹、小字号和复杂背景,所有引擎在这些情况下得分都会更低。
- 每种语言只有六句。 足以显示 60 到 90 分的差距,但不足以给两个都超过 97% 的引擎排出先后。
- 只用了一种字体和字号。 花体字和手写体对任何引擎来说都更难。
常见问题
InSnap 的 OCR 能读哪些语言?
在我们的测试中,它能以 97% 或更高的准确率读英语、德语、法语、西班牙语、葡萄牙语、意大利语,以及简体和繁体中文。日语、韩语和俄语读不准。
为什么俄语文字会被读成拉丁字母?
识别模型并不是为读西里尔字母设计的,所以它会挑出它已知的、最接近的字形。许多西里尔字母看起来像拉丁字母或数字,这就是输出看起来像乱码英文的原因。
更大的截图或更高的分辨率有帮助吗?
在这里没有。Retina 和 1x 测试图的得分相差不到 1 个百分点。限制来自模型的语言覆盖范围,而不是图像质量。
操作系统自带的 OCR 更准确吗?
对日语、韩语和俄语来说,是的:在我们的测试中,Apple Vision 接口这三种语言都达到了 99% 或以上。对英语、中文和拉丁字母语言,两者在几个百分点之内相当。
博客里的更多文章

为什么 OCR 不报错,却给出一个错字
文字识别很少说「我失败了」。它交回来的是一整句通顺的话,只有一个字是错的——偏偏就是关键的那个。本文说明这种情况从哪来、该怎么发现。
2026年10月29日
如何复制截图里的文字(Mac 与 Windows 文字识别)
把截图里的文字变成可以复制、粘贴的文本。介绍 Mac 与 Windows 自带的方法,以及用 InSnap 在本机完成的快速 OCR 流程。
2026年10月23日
如何让截图的 OCR 识别结果更准确
文字识别的好坏取决于你给它的像素。裁紧一点、保住分辨率、避开倾斜和杂乱背景,并了解它的语言限制。
2026年10月25日
截图太大无法上传?原因和缩小文件的 5 个办法
整屏 Retina 截图存成 PNG 动辄好几 MB。先看清体积从哪来,再用缩放、换格式和裁剪把文件压下去,又不把文字糊掉。
2026年10月30日