 InSnap
OCR de capture d’écran dans 11 langues : lesquelles fonctionnent

Test de l’OCR hors ligne sur 11 langues d’interface. Anglais, chinois et langues à alphabet latin : presque sans erreur. Japonais, coréen et russe : échec. Les chiffres.
L’OCR hors ligne d’InSnap a lu presque parfaitement huit des onze langues d’interface testées, et a échoué sur trois : le japonais, le coréen et le russe. L’API de reconnaissance de texte d’Apple, testée de la même façon, a lu les onze à 98 % ou plus.
La réponse à « l’OCR des captures fonctionne-t-il pour ma langue ? » n’est donc ni oui ni non. Cela dépend de l’écriture, et l’écart est assez grand pour qu’il vaille la peine de vérifier avant de vous fier à une copie.
Comment nous avons testé
Pour chaque langue, nous avons pris six phrases réelles de l’interface d’InSnap, dans la traduction de cette langue, et nous les avons rendues avec la police système de l’interface, à taille normale. Cela donne une feuille de test propre, au texte parfaitement connu. Nous avons fait chaque feuille en Retina (2x) et en 1x.
Deux moteurs ont lu chaque feuille :
- l’OCR d’InSnap, qui fonctionne entièrement sur votre ordinateur avec un modèle intégré et est identique sur Mac et Windows.
- la reconnaissance de texte Apple Vision, l’API de reconnaissance intégrée à macOS, en mode précis avec détection automatique de la langue. Nous avons testé l’API directement, et non une app particulière qui l’utilise.
Le score est la ressemblance moyenne entre ce que le moteur a lu et la phrase réelle, après avoir ignoré les espaces et la casse. 100 % signifie que chaque phrase est revenue exactement.
Les résultats
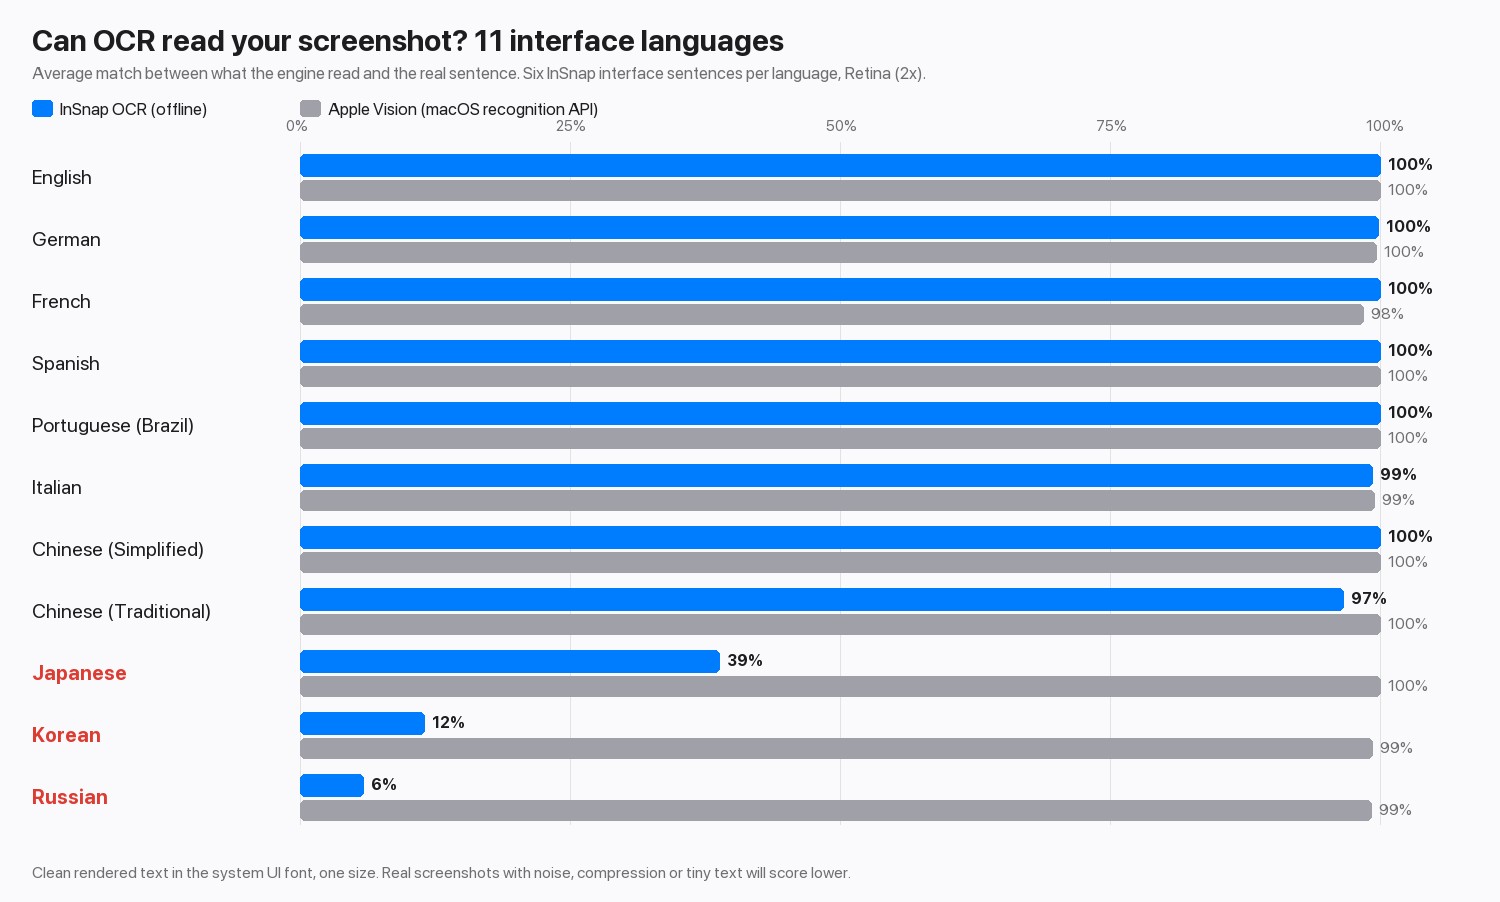
| Langue | OCR d’InSnap | Apple Vision |
|---|---|---|
| Anglais, allemand, espagnol, portugais | 100 % | 100 % |
| Français | 100 % | 98 % |
| Italien | 99 % | 99 % |
| Chinois (simplifié) | 100 % | 100 % |
| Chinois (traditionnel) | 97 % | 100 % |
| Japonais | 39 % | 100 % |
| Coréen | 12 % | 99 % |
| Russe | 6 % | 99 % |
Les feuilles Retina et 1x ont obtenu des scores à un point près l’une de l’autre : la résolution n’était donc pas en cause.
À quoi ressemble un échec
Les trois langues faibles ne sont pas mal lues : elles sont lues comme autre chose. Voici une des phrases de test, qu’un lecteur voit comme un texte parfaitement clair :
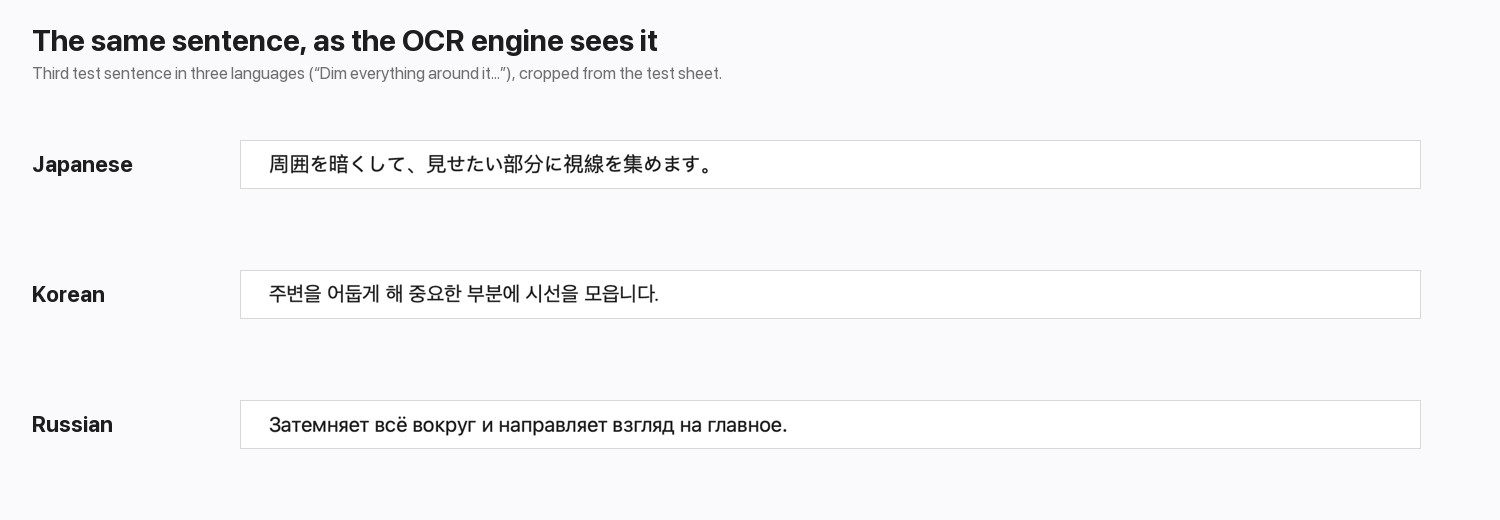
| Langue | Texte réel | L’OCR d’InSnap a renvoyé |
|---|---|---|
| Japonais | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| Coréen | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| Russe | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
Le japonais garde ses kanji, mais remplace beaucoup de kana par des kanji qui leur ressemblent. Le coréen revient sous forme de mélange de caractères chinois, de chiffres et de ponctuation. Le russe est lu comme des lettres latines et des chiffres qui ressemblent à des lettres cyrilliques. Dans les trois cas, le résultat ressemble à du texte, donc rien ne vous en avertit. (La sortie coréenne est raccourcie ici.) Le chinois traditionnel est globalement correct, mais quelques caractères sont revenus sous leurs formes simplifiées : relisez donc les noms et les citations.
Ce que cela signifie pour vous
- Anglais, chinois et langues à alphabet latin : InSnap est précis sur un texte propre. Vérifiez quand même les chiffres et les noms propres ; voir comment obtenir de meilleurs résultats OCR.
- Japonais, coréen et russe : ne copiez pas le résultat de l’OCR d’InSnap sans vérifier chaque ligne. Dans notre test, l’API de reconnaissance d’Apple a bien géré les trois : sur Mac, un outil qui l’utilise est donc le meilleur choix pour ces écritures. Nous n’avons pas testé la reconnaissance intégrée à Windows.
- Texte mixte : quand c’est possible, sélectionnez une seule écriture à la fois.
InSnap utilise un seul modèle intégré sur Mac comme sur Windows : le résultat est donc le même sur les deux, et rien n’est envoyé. Le compromis, c’est que sa couverture des langues est figée par ce modèle.
Ce que le test ne montre pas
- Uniquement du texte propre. Les captures réelles comportent de la compression, de petites tailles et des fonds chargés, et chaque moteur obtient des scores plus bas dans ces cas.
- Six phrases par langue. Assez pour montrer des écarts de 60 à 90 points, pas assez pour classer deux moteurs qui obtiennent tous deux plus de 97 %.
- Une seule police et une seule taille. Les polices stylisées et l’écriture manuscrite sont plus difficiles pour n’importe quel moteur.
Questions fréquentes
Quelles langues l’OCR d’InSnap peut-il lire ?
Dans notre test, il a lu l’anglais, l’allemand, le français, l’espagnol, le portugais, l’italien et le chinois (simplifié et traditionnel) à 97 % ou plus. Le japonais, le coréen et le russe n’étaient pas lisibles.
Pourquoi le texte russe ressort-il en lettres latines ?
Le modèle de reconnaissance n’a pas été conçu pour lire le cyrillique : il choisit les formes les plus proches de celles qu’il connaît. Beaucoup de lettres cyrilliques ressemblent à des lettres latines ou à des chiffres, d’où un résultat qui ressemble à de l’anglais brouillé.
Une capture plus grande ou une résolution plus élevée aide-t-elle ?
Pas dans ce cas. Les feuilles de test Retina et 1x ont obtenu des scores à un point près. La limite tient à la couverture linguistique du modèle, et non à la qualité de l’image.
L’OCR intégré au système d’exploitation est-il plus précis ?
Pour le japonais, le coréen et le russe, oui : dans notre test, l’API Apple Vision a lu les trois à 99 % ou plus. Pour l’anglais, le chinois et les langues à alphabet latin, les deux étaient équivalents à quelques points près.
Autres articles du blog

Pourquoi l’OCR renvoie un mauvais mot au lieu d’une erreur
La reconnaissance de texte dit rarement qu’elle a échoué. Elle rend une phrase lisible, à un caractère près — celui qui compte. Où cela arrive et comment le repérer.
29 octobre 2026
Comment copier le texte d’une capture d’écran sur Mac et Windows
Transformez les mots d’une capture d’écran en texte copiable. Options intégrées sur Mac et Windows, plus un flux OCR rapide et local avec InSnap.
23 octobre 2026
Comment obtenir de meilleurs résultats OCR sur une capture d’écran
L’OCR vaut ce que valent les pixels fournis. Recadrez serré, gardez la résolution, évitez l’inclinaison et les fonds chargés, et connaissez les limites de langue.
25 octobre 2026
Capture d’écran trop lourde pour l’envoi ? Comment la réduire
Une capture Retina plein écran peut peser plusieurs mégaoctets. D’où vient ce poids, et quels réglages d’échelle, de format et de recadrage l’allègent sans flouter le texte.
30 octobre 2026