 InSnap
OCR de capturas en 11 idiomas: cuáles funcionan y cuáles no

Probamos el OCR sin conexión en 11 idiomas de interfaz. Inglés, chino y los de escritura latina se leen casi perfectos; japonés, coreano y ruso fallaron. Las cifras.
El OCR sin conexión de InSnap leyó casi a la perfección ocho de los once idiomas de interfaz que probamos, y falló en tres: japonés, coreano y ruso. La API de reconocimiento de texto de Apple, probada de la misma forma, leyó los once al 98% o más.
Así que la respuesta a «¿funciona el OCR de capturas en mi idioma?» no es sí o no. Depende del sistema de escritura, y la diferencia es tan grande que merece la pena comprobarla antes de fiarte de una copia.
Cómo lo probamos
Para cada idioma tomamos seis frases reales de la propia interfaz de InSnap, en la traducción de ese idioma, y las dibujamos con la fuente del sistema a tamaño normal. Así se obtiene una hoja de prueba limpia con texto exactamente conocido. Hicimos cada hoja en Retina (2x) y en 1x.
Dos motores leyeron cada hoja:
- El OCR de InSnap, que funciona por completo en tu ordenador con un modelo incluido y es idéntico en Mac y Windows.
- El reconocimiento de texto Vision de Apple, la API de reconocimiento integrada en macOS, en modo preciso y con detección automática del idioma. Probamos la API directamente, no una app concreta que la use.
La puntuación es la similitud media entre lo que leyó el motor y la frase real, ignorando espacios y mayúsculas. 100% significa que cada frase salió exactamente igual.
Los resultados
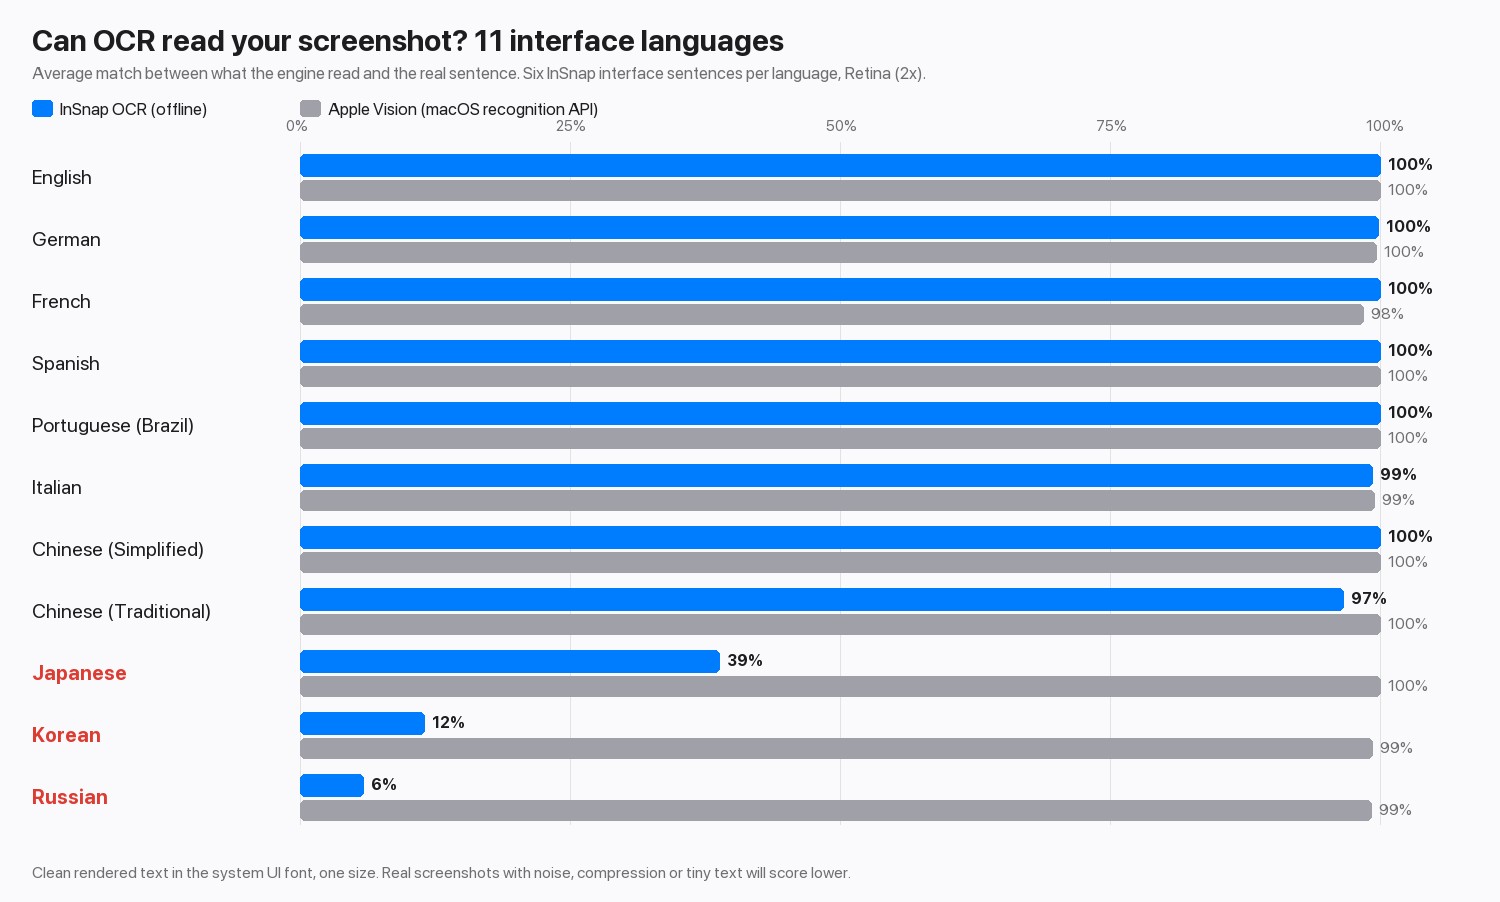
| Idioma | OCR de InSnap | Apple Vision |
|---|---|---|
| Inglés, alemán, español, portugués | 100% | 100% |
| Francés | 100% | 98% |
| Italiano | 99% | 99% |
| Chino (simplificado) | 100% | 100% |
| Chino (tradicional) | 97% | 100% |
| Japonés | 39% | 100% |
| Coreano | 12% | 99% |
| Ruso | 6% | 99% |
Las hojas Retina y 1x puntuaron con un punto de diferencia entre sí, así que la resolución no era el problema.
Cómo se ve un fallo
Los tres idiomas débiles no se leen mal, se leen como otra cosa. Esta es una de las frases de prueba, que cualquier lector ve como texto perfectamente claro:
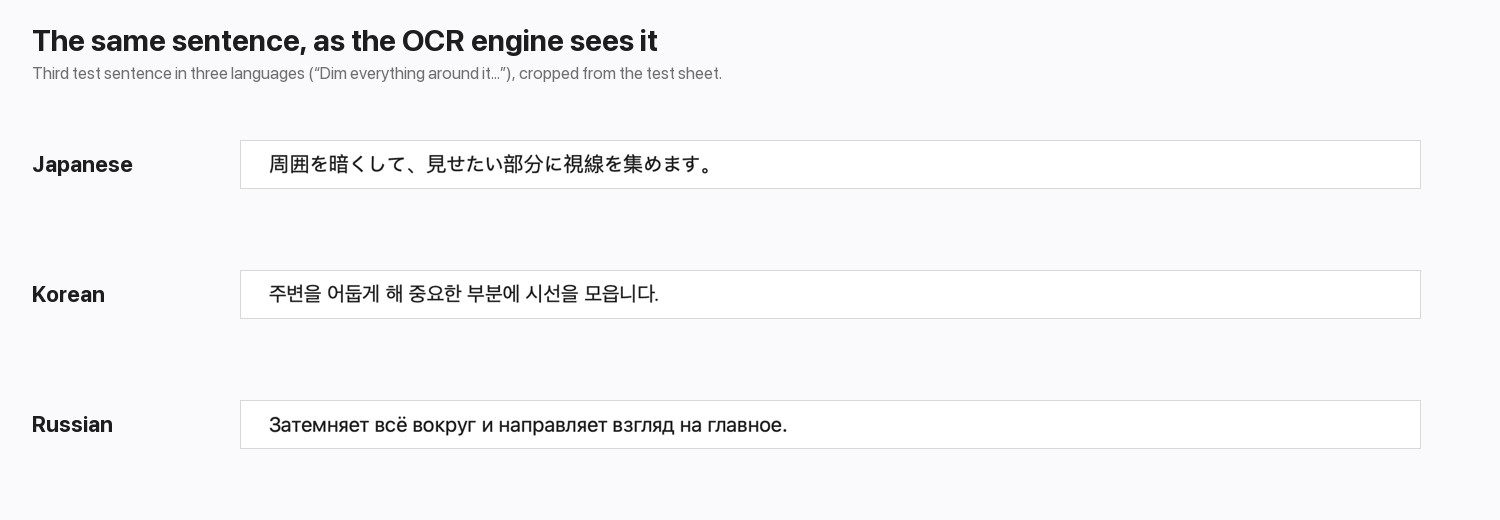
| Idioma | Texto real | Lo que devolvió el OCR de InSnap |
|---|---|---|
| Japonés | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| Coreano | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| Ruso | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
El japonés conserva sus kanji, pero cambia muchos kana por kanji que se les parecen. El coreano sale como una mezcla de caracteres chinos, dígitos y signos de puntuación. El ruso se lee como letras latinas y dígitos que se parecen a las cirílicas. En los tres casos la salida parece texto, así que nada te avisa. (La salida en coreano está acortada aquí.) El chino tradicional va en general bien, pero algunos caracteres salieron en su forma simplificada, así que revisa nombres y citas.
Qué significa para ti
- Inglés, chino y los idiomas de escritura latina: InSnap es preciso con texto limpio. Aun así, revisa números y nombres propios; consulta cómo obtener mejores resultados de OCR.
- Japonés, coreano y ruso: no copies nada del OCR de InSnap sin revisar cada línea. En nuestra prueba, la API de reconocimiento de Apple manejó los tres, así que en un Mac una herramienta que la use es mejor opción para esos sistemas de escritura. No probamos el reconocimiento integrado de Windows.
- Texto mezclado: selecciona un sistema de escritura cada vez siempre que puedas.
InSnap usa un único modelo incluido en Mac y en Windows, así que el resultado es el mismo en ambos, y no se sube nada. El inconveniente es que su cobertura de idiomas depende de ese modelo.
Lo que la prueba no muestra
- Solo texto limpio. Las capturas reales traen compresión, tamaños pequeños y fondos recargados, y todos los motores puntúan más bajo ahí.
- Seis frases por idioma. Bastan para mostrar diferencias de 60 a 90 puntos, pero no para ordenar dos motores que ambos superan el 97%.
- Una sola fuente y tamaño. Las fuentes estilizadas y la letra manuscrita son más difíciles para cualquier motor.
Preguntas frecuentes
¿Qué idiomas puede leer el OCR de InSnap?
En nuestra prueba leyó inglés, alemán, francés, español, portugués, italiano y chino (simplificado y tradicional) con un 97% o más. El japonés, el coreano y el ruso no se pudieron leer.
¿Por qué el texto en ruso sale como letras latinas?
El modelo de reconocimiento no está preparado para leer cirílico, así que elige las formas más parecidas que conoce. Muchas letras cirílicas se parecen a letras latinas o dígitos, por eso la salida parece inglés estropeado.
¿Ayuda una captura más grande o una resolución mayor?
Aquí no. Las hojas de prueba Retina y 1x puntuaron con un punto de diferencia. El límite es la cobertura de idiomas del modelo, no la calidad de la imagen.
¿El OCR integrado del sistema es más preciso?
En japonés, coreano y ruso, sí: la API Vision de Apple leyó los tres con un 99% o más en nuestra prueba. En inglés, chino y los idiomas de escritura latina, los dos estuvieron igualados con pocos puntos de diferencia.
Más del blog

Por qué el OCR devuelve la palabra equivocada en lugar de un error
El reconocimiento de texto casi nunca avisa de que ha fallado. Devuelve una frase entera con un carácter mal, justo el que importa. Aquí ves dónde pasa y cómo detectarlo.
29 de octubre de 2026
Cómo copiar el texto de una captura o imagen en Mac y Windows
Convierte las palabras de una captura en texto que puedas copiar. Opciones integradas en Mac y Windows, y un flujo de OCR local y rápido con InSnap.
23 de octubre de 2026
Cómo obtener mejores resultados de OCR en una captura
El OCR depende de los píxeles que recibe. Recorta al texto, mantén la resolución, evita la inclinación y los fondos cargados, y conoce los límites de idioma.
25 de octubre de 2026
Captura demasiado grande para subirla: causas y cómo reducirla
Una captura Retina a pantalla completa puede pesar varios MB. Descubre de dónde sale el tamaño y qué ajustes de escala, formato y recorte lo reducen sin emborronar el texto.
30 de octubre de 2026