 InSnap
Screenshot-OCR in 11 Sprachen: Was klappt und was nicht

Offline-OCR in 11 Oberflächensprachen getestet: Englisch, Chinesisch und lateinische Schriften klappen fast fehlerfrei, Japanisch, Koreanisch und Russisch nicht. Die Zahlen.
Die Offline-OCR von InSnap hat acht der elf getesteten Oberflächensprachen fast fehlerfrei gelesen und bei dreien versagt: Japanisch, Koreanisch und Russisch. Apple Vision, die Texterkennungs-API von Apple, hat, genauso getestet, alle elf mit 98% oder besser gelesen.
Die Antwort auf „Funktioniert Screenshot-OCR für meine Sprache?“ ist also weder ja noch nein. Es hängt von der Schrift ab, und der Unterschied ist groß genug, dass sich eine Prüfung lohnt, bevor du dich auf eine Kopie verlässt.
So haben wir getestet
Für jede Sprache haben wir sechs echte Sätze aus der eigenen InSnap-Oberfläche in der Übersetzung dieser Sprache genommen und in der System-Schrift der Oberfläche in normaler Größe gerendert. So entsteht ein sauberes Testblatt mit genau bekanntem Text. Jedes Blatt haben wir in Retina (2x) und in 1x erstellt.
Zwei Engines haben jedes Blatt gelesen:
- InSnaps OCR, das vollständig auf deinem Computer mit einem mitgelieferten Modell läuft und auf Mac und Windows identisch ist.
- Apple Vision, die in macOS eingebaute Texterkennungs-API, im Genauigkeitsmodus mit automatischer Spracherkennung. Wir haben die API direkt getestet, nicht eine bestimmte App, die sie nutzt.
Die Bewertung ist die durchschnittliche Ähnlichkeit zwischen dem, was die Engine gelesen hat, und dem echten Satz, nachdem Leerzeichen und Groß- und Kleinschreibung ignoriert wurden. 100% bedeutet, dass jeder Satz exakt zurückkam.
Die Ergebnisse
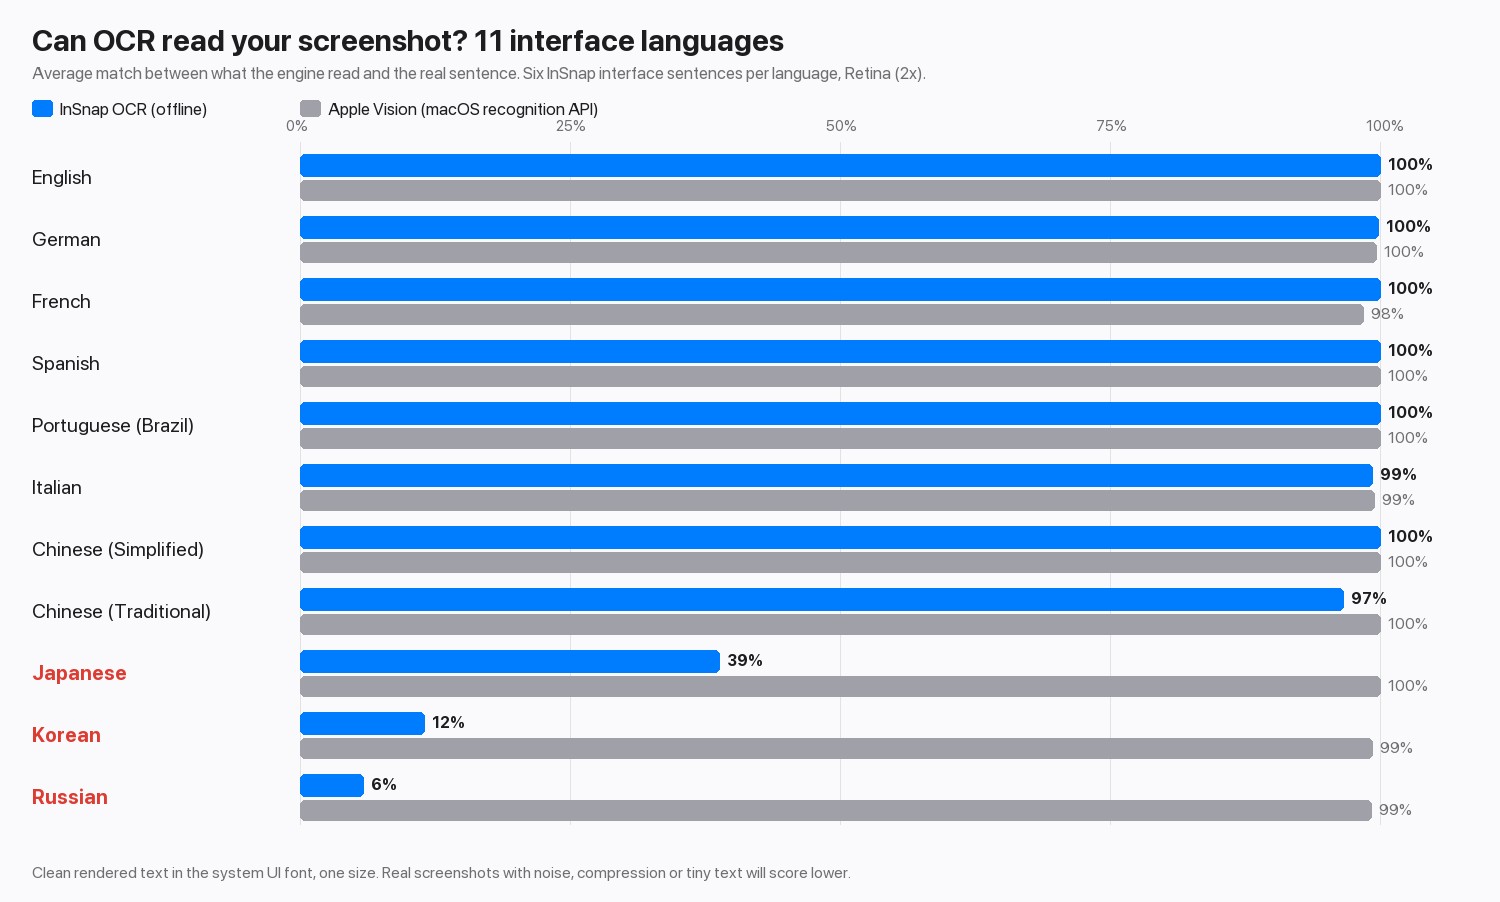
| Sprache | InSnap-OCR | Apple Vision |
|---|---|---|
| Englisch, Deutsch, Spanisch, Portugiesisch | 100% | 100% |
| Französisch | 100% | 98% |
| Italienisch | 99% | 99% |
| Chinesisch (vereinfacht) | 100% | 100% |
| Chinesisch (traditionell) | 97% | 100% |
| Japanisch | 39% | 100% |
| Koreanisch | 12% | 99% |
| Russisch | 6% | 99% |
Retina- und 1x-Blätter lagen bei den Ergebnissen innerhalb eines Punktes voneinander, die Auflösung war also nicht das Problem.
Wie ein Fehler aussieht
Die drei schwachen Sprachen werden nicht schlecht gelesen. Sie werden als etwas anderes gelesen. Hier ist einer der Testsätze, den ein Leser als völlig klaren Text sieht:
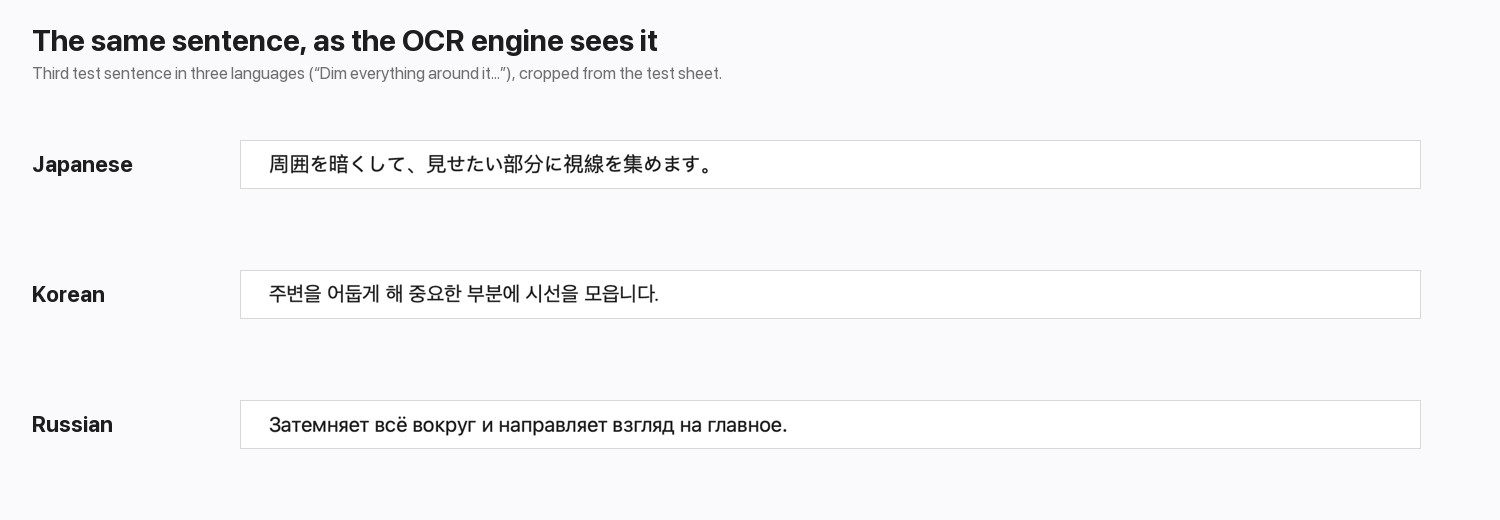
| Sprache | Echter Text | InSnap-OCR lieferte |
|---|---|---|
| Japanisch | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| Koreanisch | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| Russisch | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
Japanisch behält die Kanji, tauscht aber viele Kana gegen ähnlich aussehende Kanji aus. Koreanisch kommt als Mischung aus chinesischen Zeichen, Ziffern und Satzzeichen zurück. Russisch wird als lateinische Buchstaben und Ziffern gelesen, die kyrillischen Buchstaben ähneln. In allen drei Fällen sieht die Ausgabe nach Text aus, deshalb warnt dich nichts. (Die koreanische Ausgabe ist hier gekürzt.) Traditionelles Chinesisch ist meist in Ordnung, aber einige Zeichen kamen in ihren vereinfachten Formen zurück, also Namen und Zitate Korrektur lesen.
Was das für dich bedeutet
- Englisch, Chinesisch und lateinische Schriften: InSnap ist bei sauberem Text genau. Prüfe Zahlen und Eigennamen trotzdem; siehe So bekommst du bessere OCR-Ergebnisse aus Screenshots.
- Japanisch, Koreanisch und Russisch: Kopiere aus InSnaps OCR nicht, ohne jede Zeile zu prüfen. In unserem Test hat Apple Vision alle drei bewältigt. Auf dem Mac ist ein Werkzeug, das diese API nutzt, für diese Schriften also die bessere Wahl. Wir haben die eingebaute Texterkennung von Windows nicht getestet.
- Gemischter Text: Wähle nach Möglichkeit jeweils nur eine Schrift aus.
InSnap nutzt auf Mac und Windows dasselbe mitgelieferte Modell, das Ergebnis ist also auf beiden gleich, und nichts wird hochgeladen. Der Nachteil ist, dass die Sprachabdeckung durch dieses Modell festgelegt ist.
Was der Test nicht zeigt
- Nur sauberer Text. Echte Screenshots haben Kompression, kleine Schriftgrade und unruhige Hintergründe, und jede Engine schneidet dort schlechter ab.
- Sechs Sätze pro Sprache. Genug, um Lücken von 60 bis 90 Punkten zu zeigen, aber nicht, um zwei Engines zu ordnen, die beide über 97% liegen.
- Eine Schrift und eine Größe. Stilisierte Schriften und Handschrift sind für jede Engine schwerer.
Häufige Fragen
Welche Sprachen kann InSnaps OCR lesen?
In unserem Test las es Englisch, Deutsch, Französisch, Spanisch, Portugiesisch, Italienisch und Chinesisch (vereinfacht und traditionell) mit 97% oder besser. Japanisch, Koreanisch und Russisch waren nicht lesbar.
Warum kommt russischer Text als lateinische Buchstaben heraus?
Das Erkennungsmodell wurde nicht für kyrillische Schrift gebaut, also wählt es die ähnlichsten Formen, die es kennt. Viele kyrillische Buchstaben sehen lateinischen Buchstaben oder Ziffern ähnlich, deshalb wirkt die Ausgabe wie verstümmeltes Englisch.
Hilft ein größerer Screenshot oder eine höhere Auflösung?
Hier nicht. Die Testblätter in Retina und 1x lagen innerhalb eines Punktes beieinander. Die Grenze ist die Sprachabdeckung des Modells, nicht die Bildqualität.
Ist die eingebaute Texterkennung des Betriebssystems genauer?
Für Japanisch, Koreanisch und Russisch ja: Apple Vision hat alle drei in unserem Test mit 99% oder besser gelesen. Bei Englisch, Chinesisch und den lateinischen Schriften lagen beide bis auf wenige Punkte gleichauf.
Mehr aus dem Blog

Warum die Texterkennung das falsche Wort statt einen Fehler liefert
Texterkennung meldet selten einen Fehler. Sie liefert einen Satz mit einem falschen Zeichen zurück – dem entscheidenden. Wo das passiert und wie du es fängst.
29. Oktober 2026
So kopierst du Text aus einem Screenshot auf Mac und Windows
Wandle Wörter in einem Screenshot in kopierbaren Text um: Live Text und Snipping Tool auf Mac und Windows sowie eine schnelle lokale OCR in InSnap.
23. Oktober 2026
So bekommst du bessere OCR-Ergebnisse aus Screenshots
Texterkennung ist nur so gut wie ihre Pixel. Schneide eng zu, behalte die Auflösung, meide Schräglage und unruhige Hintergründe – und kenne die Sprachgrenzen.
25. Oktober 2026
Screenshot zu groß für den Upload? So machst du ihn kleiner
Ein Retina-PNG vom ganzen Bildschirm hat schnell mehrere MB. Woher die Größe kommt – und wie Skalierung, Format und Zuschnitt sie senken, ohne Text unscharf zu machen.
30. Oktober 2026