 InSnap
OCR degli screenshot in 11 lingue: quali funzionano e quali no

Abbiamo testato l'OCR offline su 11 lingue dell'interfaccia: inglese, cinese e lingue latine si leggono quasi perfettamente, giapponese, coreano e russo no.
L'OCR offline di InSnap ha letto quasi perfettamente otto delle undici lingue dell'interfaccia testate, e ha fallito con tre: giapponese, coreano e russo. L'API di riconoscimento del testo di Apple, testata allo stesso modo, ha letto tutte e undici con il 98% o più.
Quindi la risposta alla domanda «l'OCR degli screenshot funziona per la mia lingua?» non è sì o no. Dipende dallo script, e il divario è abbastanza grande da meritare un controllo prima di fidarsi di una copia.
Come abbiamo testato
Per ogni lingua abbiamo preso sei frasi reali dall'interfaccia di InSnap stessa, nella traduzione di quella lingua, e le abbiamo renderizzate con il font di sistema a dimensione normale. Così otteniamo una tavola di test pulita con testo esattamente noto. Abbiamo creato ogni tavola a Retina (2x) e a 1x.
Due motori hanno letto ogni tavola:
- L'OCR di InSnap, che gira interamente sul tuo computer con un modello incluso ed è identico su Mac e Windows.
- Il riconoscimento del testo Vision di Apple, l'API di riconoscimento integrata in macOS, in modalità accurata con rilevamento automatico della lingua. Abbiamo testato l'API direttamente, non una particolare app che la usa.
Il punteggio è la somiglianza media tra ciò che il motore ha letto e la frase reale, dopo aver ignorato spazi e maiuscole. 100% significa che ogni frase è tornata esattamente.
I risultati
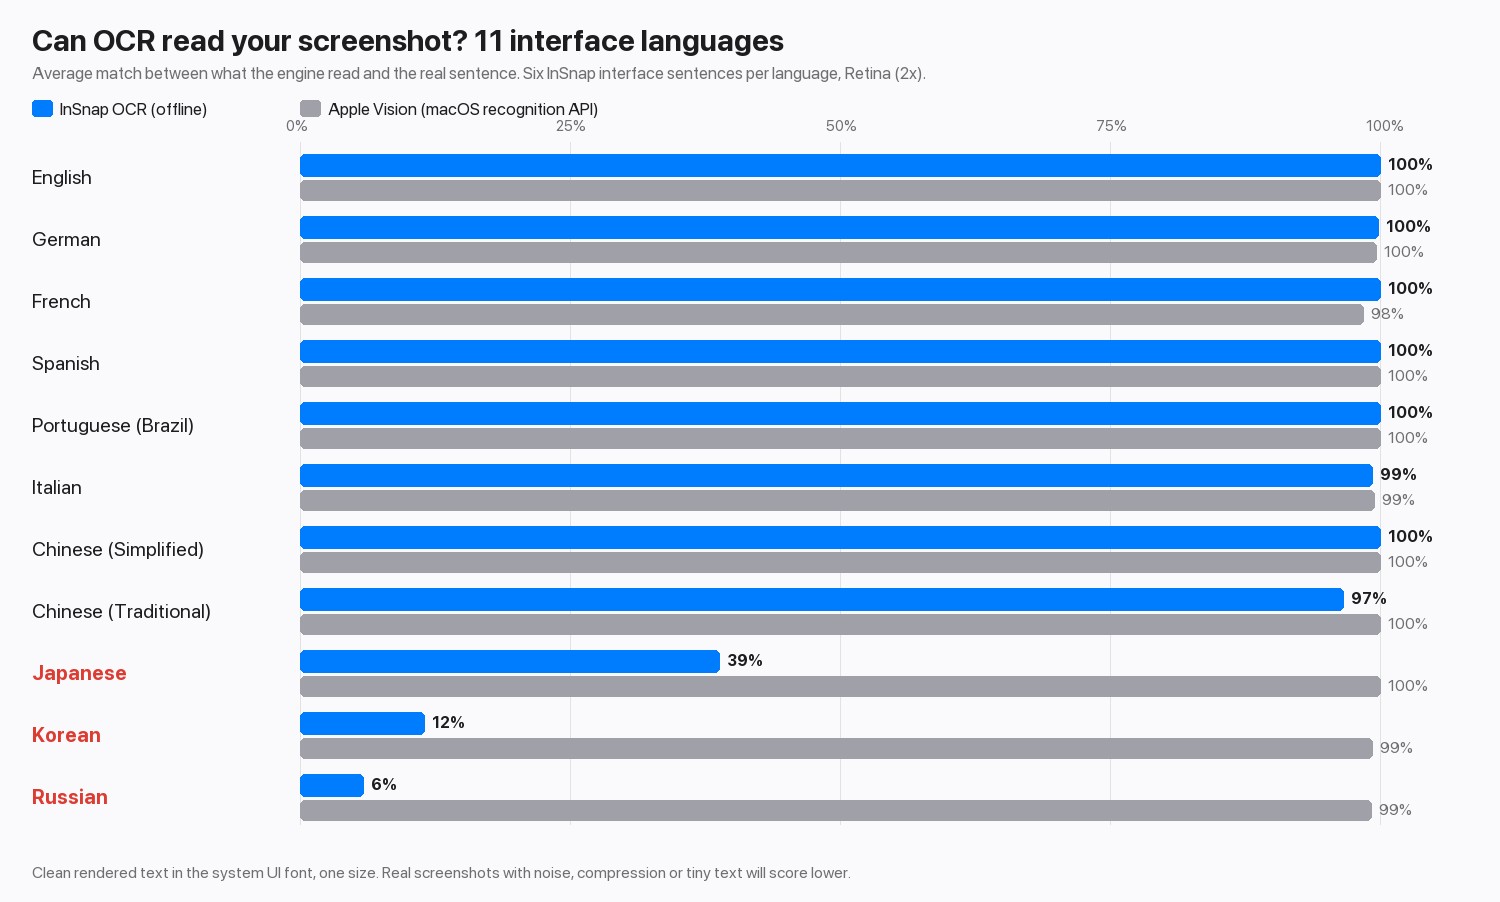
| Lingua | OCR di InSnap | Apple Vision |
|---|---|---|
| Inglese, tedesco, spagnolo, portoghese | 100% | 100% |
| Francese | 100% | 98% |
| Italiano | 99% | 99% |
| Cinese (semplificato) | 100% | 100% |
| Cinese (tradizionale) | 97% | 100% |
| Giapponese | 39% | 100% |
| Coreano | 12% | 99% |
| Russo | 6% | 99% |
Le tavole a Retina e a 1x hanno ottenuto punteggi entro un punto l'una dall'altra, quindi la risoluzione non era il problema.
Com'è un errore
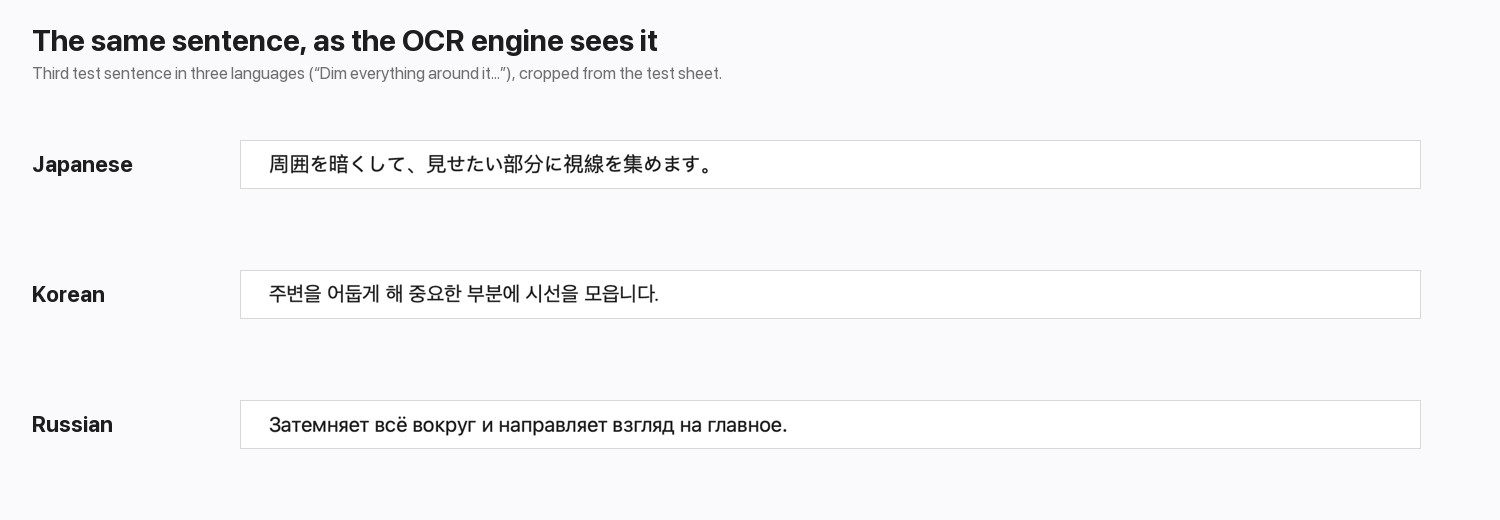
I tre idiomi deboli non vengono letti male. Vengono letti come qualcos'altro. Ecco una delle frasi di test, che un lettore vede come testo perfettamente chiaro:
| Lingua | Testo reale | Restituito dall'OCR di InSnap |
|---|---|---|
| Giapponese | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| Coreano | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| Russo | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
Il giapponese mantiene i kanji ma scambia molti kana con kanji dall'aspetto simile. Il coreano torna come un misto di caratteri cinesi, cifre e punteggiatura. Il russo viene letto come lettere latine e cifre che assomigliano a quelle cirilliche. In tutti e tre i casi l'output sembra testo, quindi nulla avverte l'utente. (L'output coreano è accorciato qui.) Il cinese tradizionale va per lo più bene, ma alcuni caratteri sono tornati nella forma semplificata, quindi rileggi con attenzione nomi e citazioni.
Cosa significa per te
- Inglese, cinese e lingue con alfabeto latino: InSnap è preciso su testo pulito. Controlla comunque numeri e nomi propri; vedi come ottenere risultati OCR migliori.
- Giapponese, coreano e russo: non copiare dall'OCR di InSnap senza controllare ogni riga. Nel nostro test l'API di riconoscimento di Apple ha gestito tutti e tre, quindi su un Mac uno strumento che la usa è la scelta migliore per quegli script. Non abbiamo testato il riconoscimento integrato di Windows.
- Testo misto: dove puoi, seleziona uno script alla volta.
InSnap usa un unico modello incluso su Mac e Windows, quindi il risultato è lo stesso su entrambi e nulla viene caricato. Il compromesso è che la copertura linguistica è fissata da quel modello.
Cosa non mostra il test
- Solo testo pulito. Gli screenshot reali hanno compressione, dimensioni ridotte e sfondi affollati, e ogni motore ottiene punteggi più bassi lì.
- Sei frasi per lingua. Bastano a mostrare divari di 60–90 punti, non a classificare due motori che superano entrambi il 97%.
- Un solo font e una sola dimensione. Font stilizzati e scrittura a mano sono più difficili per qualunque motore.
Domande frequenti
Quali lingue può leggere l'OCR di InSnap?
Nel nostro test ha letto inglese, tedesco, francese, spagnolo, portoghese, italiano e cinese (semplificato e tradizionale) con il 97% o più. Giapponese, coreano e russo non erano leggibili.
Perché il testo russo esce come lettere latine?
Il modello di riconoscimento non è stato costruito per leggere il cirillico, quindi sceglie le forme più vicine che conosce. Molte lettere cirilliche assomigliano a lettere latine o cifre, ed è per questo che l'output sembra inglese corrotto.
Uno screenshot più grande o una risoluzione più alta aiutano?
Qui no. Le tavole di test a Retina e a 1x hanno ottenuto punteggi entro un punto l'una dall'altra. Il limite è la copertura linguistica del modello, non la qualità dell'immagine.
L'OCR integrato del sistema operativo è più preciso?
Per giapponese, coreano e russo, sì: nel nostro test l'API Vision di Apple ha letto tutti e tre con il 99% o più. Per inglese, cinese e le lingue con alfabeto latino i due erano alla pari, entro pochi punti.
Altro dal blog

Perché l'OCR ti restituisce la parola sbagliata invece di un errore
Il riconoscimento testo raramente dice di aver fallito. Restituisce una frase intera con un carattere sbagliato — quello che conta. Ecco dove accade e come accorgersene.
29 ottobre 2026
Come copiare il testo da uno screenshot o un'immagine su Mac e Windows
Trasforma le parole di uno screenshot in testo copiabile. Le opzioni integrate di Mac e Windows e un flusso OCR rapido, sul dispositivo, con InSnap.
23 ottobre 2026
Come ottenere risultati OCR migliori da uno screenshot
Il riconoscimento del testo vale quanto i pixel che gli dai. Ritaglia stretto, mantieni la risoluzione, evita inclinazioni e sfondi caotici e conosci i limiti di lingua.
25 ottobre 2026
Screenshot troppo grande da caricare? Perché succede e come ridurlo
Uno screenshot Retina a schermo intero può arrivare a diversi megabyte. Ecco da dove viene il peso e quali impostazioni di scala e formato lo riducono senza sfocare il testo.
30 ottobre 2026