 InSnap
OCR de capturas de tela em 11 idiomas: quais funcionam e quais não

Testamos OCR offline em 11 idiomas de interface. Inglês, chinês e os idiomas de alfabeto latino quase não erram; japonês, coreano e russo falharam. Os números.
O OCR offline do InSnap leu quase perfeitamente oito dos onze idiomas de interface que testamos, e falhou em três: japonês, coreano e russo. A API de reconhecimento de texto da Apple, testada da mesma forma, leu os onze com 98% ou mais.
Por isso, a resposta para "o OCR de capturas funciona no meu idioma?" não é sim ou não. Depende da escrita, e a diferença é grande o bastante para valer a pena conferir antes de confiar em uma cópia.
Como testamos
Para cada idioma, pegamos seis frases reais da própria interface do InSnap, na tradução daquele idioma, e as renderizamos na fonte do sistema em tamanho normal. Assim obtemos uma folha de teste limpa com um texto exatamente conhecido. Fizemos cada folha em Retina (2x) e em 1x.
Dois mecanismos leram cada folha:
- O OCR do InSnap, que roda inteiramente no seu computador com um modelo incluído e é idêntico no Mac e no Windows.
- Apple Vision, o reconhecimento de texto da Apple embutido no macOS, no modo preciso com detecção automática de idioma. Testamos a API diretamente, não um app específico que a utiliza.
A pontuação é a semelhança média entre o que o mecanismo leu e a frase real, ignorando espaços e maiúsculas. 100% significa que todas as frases voltaram exatamente iguais.
Os resultados
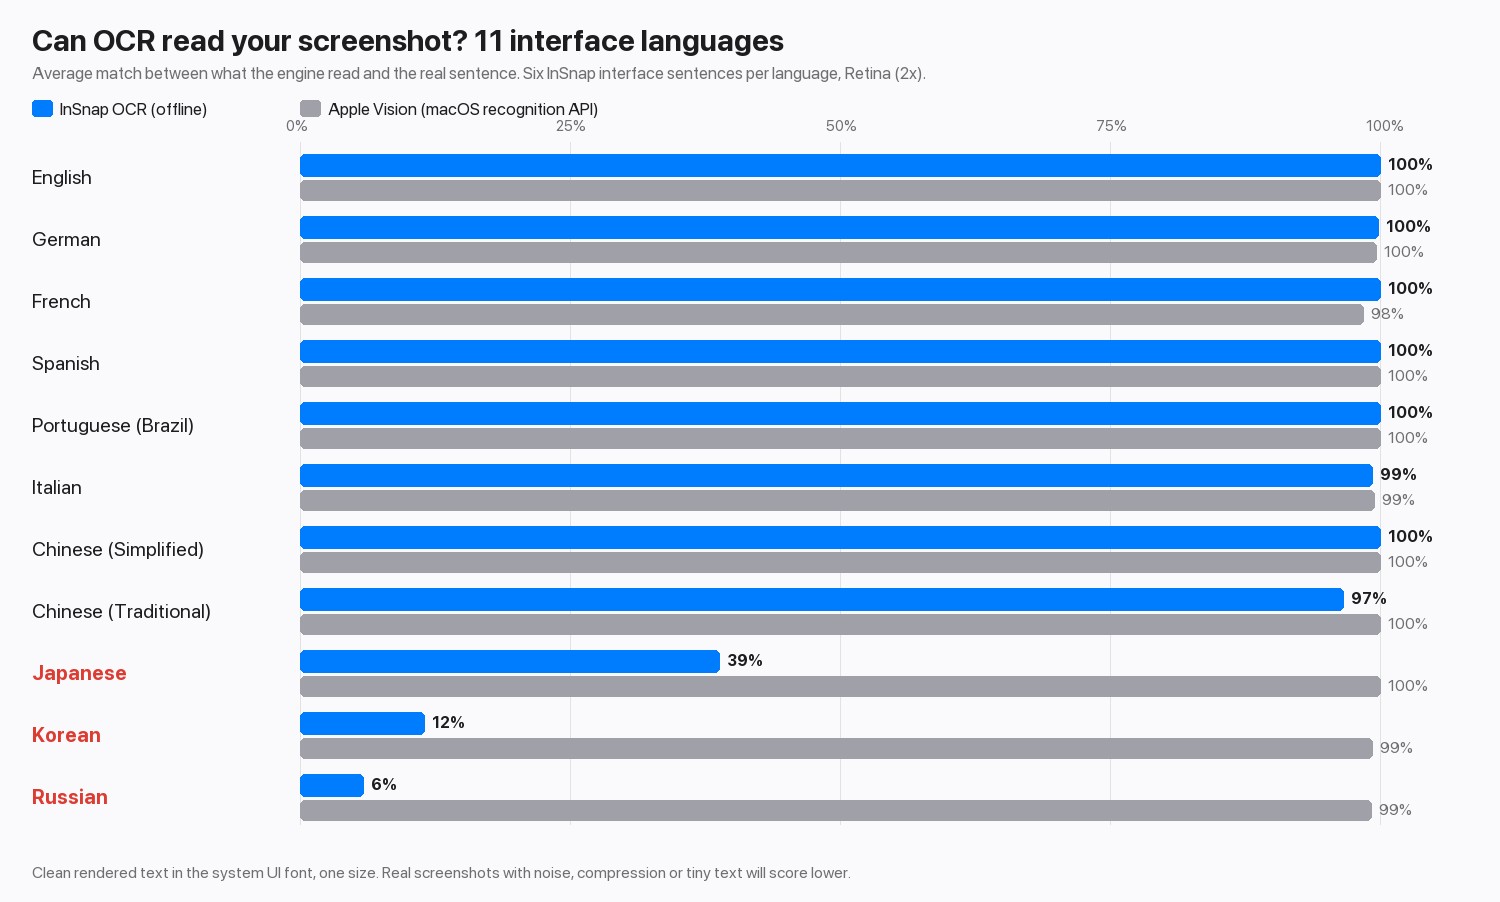
| Idioma | OCR do InSnap | Apple Vision |
|---|---|---|
| Inglês, alemão, espanhol, português | 100% | 100% |
| Francês | 100% | 98% |
| Italiano | 99% | 99% |
| Chinês (simplificado) | 100% | 100% |
| Chinês (tradicional) | 97% | 100% |
| Japonês | 39% | 100% |
| Coreano | 12% | 99% |
| Russo | 6% | 99% |
As folhas em Retina e em 1x ficaram a menos de um ponto uma da outra, então a resolução não foi o problema.
Como é uma falha
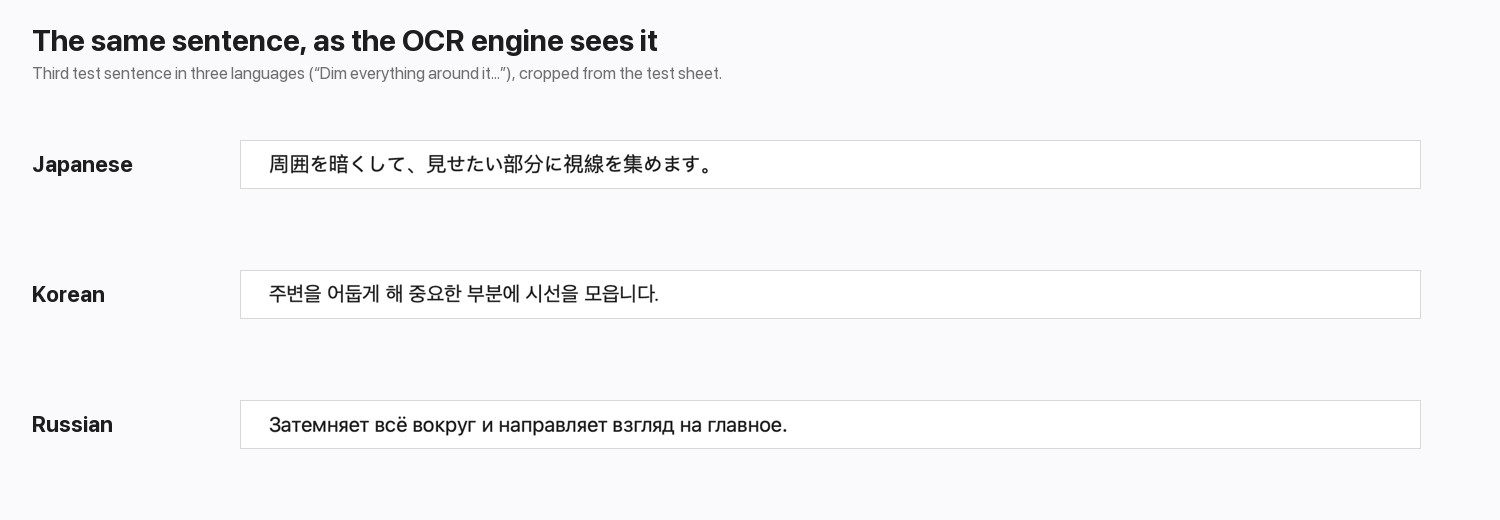
Os três idiomas fracos não são lidos mal; são lidos como outra coisa. Aqui está uma das frases de teste, que um leitor vê como texto perfeitamente claro:
| Idioma | Texto real | O OCR do InSnap devolveu |
|---|---|---|
| Japonês | 周囲を暗くして、見せたい部分に視線を集めます。 | 周田左暗<、見世左八部分仁視線左集末寸。 |
| Coreano | 주변을 어둡게 해 중요한 부분에 시선을 모읍니다. | 牲号号列刮吞2勃早是人刈号卫号L… |
| Russo | Затемняет всё вокруг и направляет взгляд на главное. | 3aTeMHgeT Bcë BOKpyr V HanpaBIgeT B3rnA Ha rnaBHoe. |
O japonês mantém os kanji, mas troca muitos kana por kanji parecidos. O coreano volta como uma mistura de caracteres chineses, números e pontuação. O russo é lido como letras latinas e números que se parecem com as cirílicas. Nos três casos a saída parece texto, então nada avisa que houve erro. (A saída coreana está encurtada aqui.) O chinês tradicional está quase sempre certo, mas alguns caracteres voltaram na forma simplificada, então revise nomes e citações.
O que isso significa para você
- Inglês, chinês e idiomas de alfabeto latino: o InSnap é preciso em texto limpo. Confira números e nomes próprios mesmo assim; veja como obter resultados de OCR melhores.
- Japonês, coreano e russo: não copie do OCR do InSnap sem conferir cada linha. No nosso teste, a API de reconhecimento da Apple lidou com os três, então em um Mac uma ferramenta que a utiliza é a melhor escolha para essas escritas. Não testamos o reconhecimento embutido do Windows.
- Texto misturado: quando possível, selecione uma escrita de cada vez.
O InSnap usa um único modelo incluído tanto no Mac quanto no Windows, então o resultado é o mesmo nos dois, e nada é enviado. A contrapartida é que a cobertura de idiomas é fixa, definida por esse modelo.
O que o teste não mostra
- Só texto limpo. Capturas reais têm compressão, tamanhos pequenos e fundos carregados, e todos os mecanismos pontuam menos nesses casos.
- Seis frases por idioma. Bastante para mostrar diferenças de 60 a 90 pontos, mas não para ordenar dois mecanismos que ambos passam de 97%.
- Uma fonte e um tamanho. Fontes estilizadas e letra manuscrita são mais difíceis para qualquer mecanismo.
Perguntas frequentes
Quais idiomas o OCR do InSnap consegue ler?
No nosso teste, ele leu inglês, alemão, francês, espanhol, português, italiano e chinês (simplificado e tradicional) com 97% ou mais. Japonês, coreano e russo não foram legíveis.
Por que o texto em russo sai com letras latinas?
O modelo de reconhecimento não foi feito para ler cirílico, então escolhe as formas mais próximas que conhece. Muitas letras cirílicas se parecem com letras latinas ou números, e por isso a saída parece inglês embaralhado.
Uma captura maior ou uma resolução mais alta ajuda?
Aqui, não. As folhas Retina e 1x ficaram a menos de um ponto uma da outra. O limite é a cobertura de idiomas do modelo, não a qualidade da imagem.
O OCR embutido do sistema operacional é mais preciso?
Para japonês, coreano e russo, sim: a API Apple Vision leu os três com 99% ou mais no nosso teste. Para inglês, chinês e os idiomas de alfabeto latino, os dois ficaram iguais, com poucos pontos de diferença.
Mais do blog

Por que o OCR devolve a palavra errada em vez de um erro
O reconhecimento de texto raramente avisa que falhou. Ele devolve uma frase inteira com um caractere errado — justo o que importa. Veja onde isso acontece e como notar.
29 de outubro de 2026
Como copiar texto de uma captura de tela ou imagem no Mac e Windows
Transforme as palavras de uma captura de tela em texto que você pode copiar. Opções nativas no Mac e no Windows, além de um fluxo rápido de OCR local com o InSnap.
23 de outubro de 2026
Como obter melhores resultados de OCR em uma captura de tela
O reconhecimento de texto depende dos pixels que você fornece. Corte justo, preserve a resolução, evite inclinação e fundos carregados e conheça os limites.
25 de outubro de 2026
Captura de tela grande demais para enviar? Como reduzir o arquivo
Uma captura Retina de tela cheia pode chegar a vários megabytes. Veja de onde vem o tamanho e quais ajustes de escala, formato e recorte resolvem sem borrar o texto.
30 de outubro de 2026